1
迁移学习综述
庄富镇、齐志远、段克雨、席东博、朱永春、朱恒殊(IEEE 高级会员)、熊辉(IEEE 会士)、何清
摘要 {#sec-abstract}
迁移学习旨在通过迁移不同但相关的源领域中所蕴含的知识,来提升目标学习者在目标领域上的性能表现。由此可以降低构建目标学习者对大量目标领域数据的依赖。由于其广阔的应用前景,迁移学习已成为机器学习中一个热门且极具潜力的研究方向。尽管目前已有一些颇具价值与影响力的迁移学习综述,但这些综述往往以相对孤立的方式介绍各类方法,且未能涵盖迁移学习的最新进展。随着迁移学习领域的快速拓展,对相关研究进行全面梳理既十分必要,也充满挑战。本综述致力于对现有迁移学习研究进行系统化梳理与有机整合,并以全面而深入的方式归纳和阐释迁移学习的机制与策略,以期帮助读者更好地把握该领域的研究现状与研究思路。与以往综述不同,本文从数据和模型两个视角出发,综述了四十余种代表性迁移学习方法,尤其是同构迁移学习方法,并对迁移学习的应用进行了简要介绍。为了展示不同迁移学习模型的性能,本文选取了二十余种代表性模型进行实验,分别在 Amazon Reviews、Reuters-21578 和 Office-31 三个数据集上开展对比。实验结果表明,在实际应用中针对不同任务选择恰当的迁移学习模型具有重要意义。
关键词——迁移学习、机器学习、领域自适应、可解释性
1 引言 {#sec-1}
A
尽管传统机器学习技术已取得巨大成功,并被成功应用于众多实际场景,但在某些真实业务情境中仍存在一定的局限性。机器学习的理想情形是拥有充足且与测试数据同分布的标注训练样本。然而,在许多场景下,收集足够的训练数据往往成本高昂、耗时漫长,甚至难以实现。半监督学习通过放宽对大量标注数据的需求,可在一定程度上缓解该问题。典型的半监督方法仅需少量标注数据,并利用大量未标注数据来提升学习精度。但在很多情况下,未标注实例同样难以收集,这通常使得所训练的传统模型效果难以令人满意。迁移学习聚焦于跨领域知识迁移,是解决上述问题的一种颇具前景的机器学习方法论。迁移学习的概念最初可追溯至教育心理学。根据心理学家 C. H. Judd 所提出的迁移概括说,学习中的迁移是经验概括化的结果,是有可能实现从一种情境到另一种情境的迁移的。
• 庄富镇、齐志远、段克雨、席东博、朱永春、何清任职于中国科学院计算技术研究所智能信息处理重点实验室(北京 100190),并在中国科学院大学(北京 100049)任职。 • 朱恒殊任职于百度公司,北京市海淀区上地十街 10 号。 • 熊辉任职于罗格斯新泽西州立大学,美国新泽西州纽瓦克市华盛顿公园 1 号。 • 齐志远与第一作者贡献相同。 • 庄富镇与齐志远为本文通信作者,邮箱:zhuangfuzhen@ict.ac.cn 和 qizhyuan@gmail.com。
✦
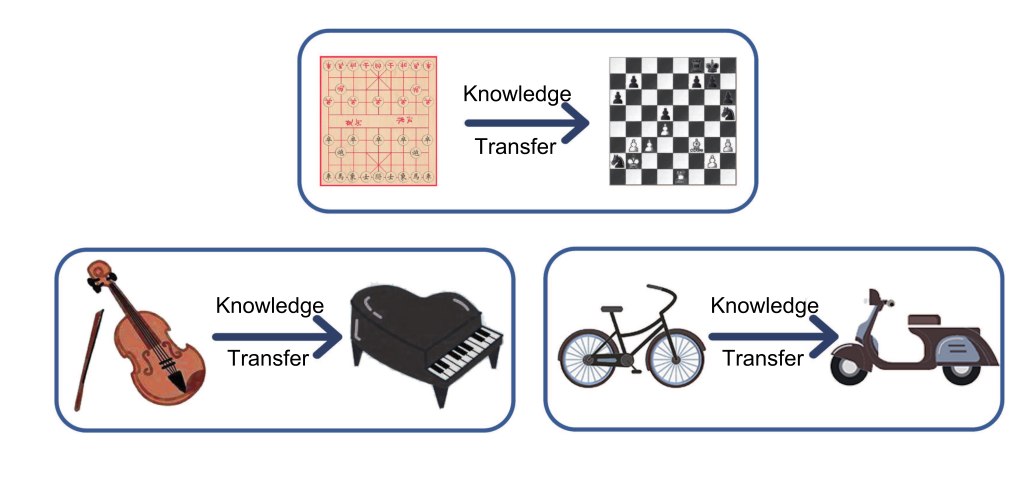
只要人能够对其经验进行概括。根据该理论,迁移的前提是两个学习活动之间需要存在某种联系。在实践中,已经学会小提琴的人学习钢琴会比其他人更快,因为小提琴和钢琴都属于乐器,可能共享一些共通的知识。图1展示了一些关于迁移学习的直观示例。受到人类跨领域迁移知识能力的启发,迁移学习旨在利用来自相关领域(称为源领域)的知识,以提升目标领域的学习性能或减少所需的标注样本数量。值得一提的是,所迁移的知识并不总是对新的任务产生积极影响。如果两个领域之间几乎没有共性,知识迁移就可能无法取得成效。例如,学会骑自行车并不能帮助我们更快地学会弹钢琴。此外,领域之间的相似性也并不总能促进学习,因为有时这些相似性可能产生误导。例如,虽然西班牙语和法语彼此关系密切,同属罗曼语族,但学习西班牙语的人在学习法语时可能会遇到困难,如使用错误的词汇或动词变位。这是由于先前在西班牙语中的成功经验会干扰对法语中构词、用法、发音、动词变位等方面的学习。在心理学领域,先前经验对新任务的学习产生负面作用的现象被称为负迁移[1]。类似地,在迁移学习领域,如果目标学习者受到所迁移知识的负面影响,这一现象也被称为负迁移[2]、[3]。是否会发生负迁移可能取决于若干因素,例如源领域与目标领域之间的相关性,以及学习者发现跨领域可迁移且有益的知识的能力。文献[3]给出了负迁移的形式化定义及若干分析。
2
对于一组相近的语言,学习过西班牙语的人在学习法语时可能会遇到困难,例如使用错误的词汇或动词变位。这是因为先前在西班牙语方面的成功经验会干扰对法语构词、用法、发音、变位等方面的学习。在心理学领域,先前经验对新任务的学习产生负面影响的现象被称为负迁移[1]。类似地,在迁移学习领域中,如果目标学习者受到所迁移知识的负面影响,该现象同样被称为负迁移[2]、[3]。负迁移是否会发生可能取决于若干因素,例如源领域与目标领域之间的相关性,以及学习者在跨领域中发现可迁移且有益的知识的能力。文献[3]给出了负迁移的形式化定义及若干分析。 粗略而言,根据领域之间的差异,迁移学习可进一步划分为两大类,即同构迁移学习与异构迁移学习[4]。同构迁移学习方法针对领域具有相同特征空间的情形而设计提出。在同构迁移学习中,部分研究假设领域仅在边际分布上存在差异,因此通过修正样本选择偏差[5]或协变量偏移[6]来对领域进行适配。然而,这一假设在很多情况下并不成立。例如,在情感分类问题中,同一个词在不同领域可能具有不同的语义倾向,这种现象也被称为上下文特征偏差[7]。为解决该问题,一些研究进一步对条件分布进行适配。异构迁移学习则是指在领域具有不同特征空间的情形下进行的知识迁移过程;除分布适配外,异构迁移学习还需要进行特征空间适配[7],这使其比同构迁移学习更为复杂。 本综述旨在从数据和模型两个视角,使读者对迁移学习形成全面的认识。本文介绍迁移学习方法的机制与策略,以帮助读者理解这些方法的工作原理,并将大量现有迁移学习研究加以关联和系统化。具体而言,本文介绍了四十余种具有代表性的迁移学习方法。此外,我们还通过实验展示迁移学习模型在哪些数据集上表现良好。 在本综述中,我们将重点放在同构迁移学习上。一些有趣的迁移学习主题未在本文中涵盖,例如强化迁移学习[8]、终身迁移学习[9]以及在线迁移学习[10]。本综述其余部分共分为七个章节:第2章阐明迁移学习与其他相关机器学习技术之间的区别;第3章介绍本文所使用的符号以及迁移学习的相关定义;第4章和第5章分别从数据和模型视角对迁移学习方法进行解读;第6章介绍迁移学习的一些应用;第7章给出实验及结果;最后一章对全文进行总结。本综述的主要贡献概括如下。
• 介绍并总结了四十余种具有代表性的迁移学习方法,能够为读者提供关于迁移学习的全面概览。
• 通过实验对比不同的 transfer learning 方法。直观地展示了二十余种方法的性能并进行深入分析,可为读者在实际应用中选取合适的方法提供参考。
2 相关工作 {#sec-2}
本节介绍与 transfer learning 相关的若干领域,并阐明它们与 transfer learning 之间的联系与区别。 半监督学习 [11]:半监督学习是一项介于监督学习(所有样本均带有标记)与无监督学习(所有样本均无标记)之间的机器学习任务与方法。典型的半监督方法利用大量未标记样本与少量已标记样本共同训练学习器,从而降低对已标记样本的依赖,减少昂贵的标注成本。需要注意的是,在半监督学习中,已标记样本与未标记样本来自同一分布;而在 transfer learning 中,源域与目标域的数据分布通常不同。许多 transfer learning 方法吸收了半监督学习的技术,平滑性、聚类与流形等半监督学习中的关键假设也被引入到 transfer learning 中。值得一提的是,半监督 transfer learning 这一术语存在争议,因为在 transfer learning 中,对于源域和目标域是否提供标签信息并无明确界定。 多视图学习 [12]:多视图学习关注于具有多视图数据的机器学习问题,每个视图对应一组不同的特征。一个直观的例子是,视频对象可以从图像信号和音频信号两个不同视角进行描述。简而言之,多视图学习从多个视角刻画同一对象,可获得更丰富的信息。通过合理融合来自所有视图的信息,学习器的性能能够得到提升。多视图学习采用的策略包括子空间学习、多核学习与协同训练 [13]、[14] 等。多视图技术也被部分 transfer learning 方法所采用:例如,Zhang 等人提出了一个多视图 transfer learning 框架,在多个视图之间施加一致性约束 [15];Yang 和 Gao 将跨域的多视图信息引入知识迁移过程 [16];Feuz 和 Cook 则面向异构传感器平台之间的活动知识迁移,提出了一种多视图 transfer learning 方法用于活动学习 [17]。 多任务学习 [18]:多任务学习的核心思想是联合学习一组相关任务。具体而言,它通过利用任务之间的相互联系,即同时考虑任务间相关性以及任务间差异,使每个任务的性能都得到增强,从而提高各任务的泛化能力。transfer learning 与多任务学习的主要区别在于:前者迁移来自相关领域的知识,而后者通过同时学习若干相关任务来实现知识迁移。换言之,多任务学习对各任务一视同仁,transfer learning 则更关注目标任务而非源任务。两者之间也存在一定的共通与关联,二者均旨在通过知识迁移提升学习器的性能,并且采用了相似的建模策略,如特征变换与参数共享。值得注意的是,已有研究将 transfer learning 与多任务学习技术相结合。例如,Zhang 等人的工作将多任务与 transfer learning 技术用于生物图像分析 [19];Liu 等人则基于多任务学习和多源 transfer learning 构建了用于人体动作识别的框架 [20]。
差异性。在这种方式下,每个任务的泛化能力都得到增强。transfer learning 与多任务学习的主要区别在于:前者迁移来自相关领域的知识,而后者通过同时学习若干相关任务来实现知识迁移。换言之,多任务学习对各任务一视同仁,而 transfer learning 则更关注目标任务而非源任务。transfer learning 与多任务学习之间存在一定的共通与关联,二者均旨在通过知识迁移提升学习器的性能,并且采用了相似的建模策略,如特征变换与参数共享。需要注意的是,已有研究将 transfer learning 与多任务学习技术相结合。例如,Zhang 等人将多任务与 transfer learning 技术用于生物图像分析 [19],Liu 等人则基于多任务学习与多源 transfer learning 提出了用于人体动作识别的框架 [20]。
3 概述 {#sec-3}
本节列出了本综述所使用的符号,以便阅读。此外,还介绍了 transfer learning 的一些定义与分类,并给出了相关的综述文献。
3.1 符号说明 {#sec-3-1}
为方便起见,符号及其定义列于表 1 中。此外,本文使用 ||·|| 表示范数,并使用上标 T 表示向量或矩阵的转置。
3.2 定义 {#sec-3-2}
本小节给出迁移学习的一些相关定义。在给出迁移学习的定义之前,先回顾领域和任务的定义。 定义 1.(领域)领域 D 由两部分组成,即特征空间 X 和边缘分布 P(X)。换言之,D = {X, P(X)}。符号 X 表示实例集,定义为 X = {x | x_i ∈ X, i = 1, ⋯, n}。
定义 2.(任务)任务 T 由标签空间 Y 和决策函数 f 组成,即 T = {Y, f}。决策函数 f 是隐式的,期望从样本数据中学习得到。
一些机器学习模型实际上输出实例的预测条件分布。在这种情况下,f(x_j) = {P(y_k|x_j) | y_k ∈ Y, k = 1, ⋯, |Y|}。 实践中,领域通常通过若干带有或不带标签信息的实例来观测。例如,与源任务 T^S 对应的源领域 D^S 一般通过实例-标签对来观测,即 D^S = {(x, y) | x_i ∈ X^S, y_i ∈ Y^S, i = 1, ⋯, n^S};而目标领域的观测通常由若干无标签实例和/或有限数量的有标签实例组成。 定义 3.(迁移学习)给定对应于 m^S ∈ ℕ^+ 个源领域和源任务的一些/一个观测(即 {(D_i^S, T_i^S) | i = 1, ⋯, m^S}),以及关于 m^T ∈ ℕ^+ 个目标领域和目标任务的一些/一个观测(即 {(D_j^T, T_j^T) | j = 1, ⋯, m^T}),迁移学习利用源领域中所蕴含的知识来提高在目标领域上学到的决策函数 f_j^T(j = 1, ⋯, m^T)的性能。
3
表 1 符号表。
符号 定义
n 实例数量 m 领域数量 D 领域 T 任务 X 特征空间 Y 标签空间 x 特征向量 y 标签 X 实例集 Y 对应于 X 的标签集 S 源领域 T 目标领域 L 有标签实例 U 无标签实例 H 再生核希尔伯特空间 θ 映射/系数向量 α 加权系数 β 加权系数 λ 权衡参数 δ 参数/误差 b 偏置 B 边界参数 N 迭代次数/核数 f 决策函数 L 损失函数 η 尺度参数 G 图 Φ 非线性映射 σ 单调递增函数 Ω 结构风险 κ 核函数 K 核矩阵 H 中心化矩阵 C 协方差矩阵 d 文档 w 词 z 类别变量 ˜z 噪声 D 判别器 G 生成器 S 函数 M 正交基 Θ 模型参数 P 概率 E 期望 Q 矩阵变量 R 矩阵变量 W 映射矩阵
(即 {(D_i^S, T_i^S) | i = 1, ⋯, m^S}),以及关于 m^T ∈ ℕ^+ 个目标领域和目标任务的一些/一个观测(即 {(D_j^T, T_j^T) | j = 1, ⋯, m^T}),迁移学习利用源领域中所蕴含的知识来提高在目标领域上学到的决策函数 f_j^T(j = 1, ⋯, m^T)的性能。
上述定义涵盖了多源迁移学习的场景,是对综述 [2] 中定义的扩展。若 m^S 等于 1,则称为单源迁移学习;否则称为多源迁移学习。此外,m^T 表示迁移学习任务的数量。少数研究关注 m^T ≥ 2 的设定 [21]。现有的迁移学习研究更多关注 m^T = 1 的场景(特别是 m^S = m^T = 1 的情形)。值得指出的是,领域或任务的观测是一个含义广泛的概念,通常具体化为一个带标签/不带标签的实例集或一个预训练模型。一个常见的场景是:在源领域上拥有丰富的有标签实例或训练良好的模型,而在目标领域仅有有限的有标签实例。在这种情况下,实例和模型等资源实际上就是观测,迁移学习的目标是学习一个在目标领域上更为准确的决策函数。 迁移学习领域中另一个常用的术语是领域自适应。领域自适应指将一个或多个源领域进行适配以迁移知识并提升目标学习器性能的过程 [4]。迁移学习通常依赖于领域自适应过程,该过程旨在缩小不同领域之间的差异。
意义,并且通常具体化为带标签/不带标签的实例集或预训练模型。一个常见的情形是:在源领域上拥有大量有标签实例或训练良好的模型,而目标领域仅有有限的有标签实例。在这种情况下,实例和模型等资源实际上就是观测,迁移学习的目标是学习一个在目标领域上更为准确的决策函数。 迁移学习领域中另一个常用术语是领域自适应。领域自适应指将一个或多个源领域进行适配以迁移知识并提升目标学习器性能的过程 [4]。迁移学习通常依赖于领域自适应过程,该过程旨在缩小不同领域之间的差异。
3.3 迁移学习的分类 {#sec-3-3}
迁移学习存在多种分类标准。例如,迁移学习问题可划分为三类,即直推式、归纳式和无监督迁移学习[2]。这三类的完整定义见文献[2]。从标签设定的角度可以对这三类进行解读:粗略而言,直推式迁移学习指标签信息仅来自源域的情形;若目标域样本带有标签信息,则该场景可归为归纳式迁移学习;若源域和目标域的标签信息均未知,则该情形称为无监督迁移学习。另一种分类基于源域与目标域在特征空间和标签空间上的一致性:若源域和目标域的特征空间相同且标签空间相同,则该场景称为同构迁移学习;反之,若两者的特征空间和/或标签空间不同,则该场景称为异构迁移学习。
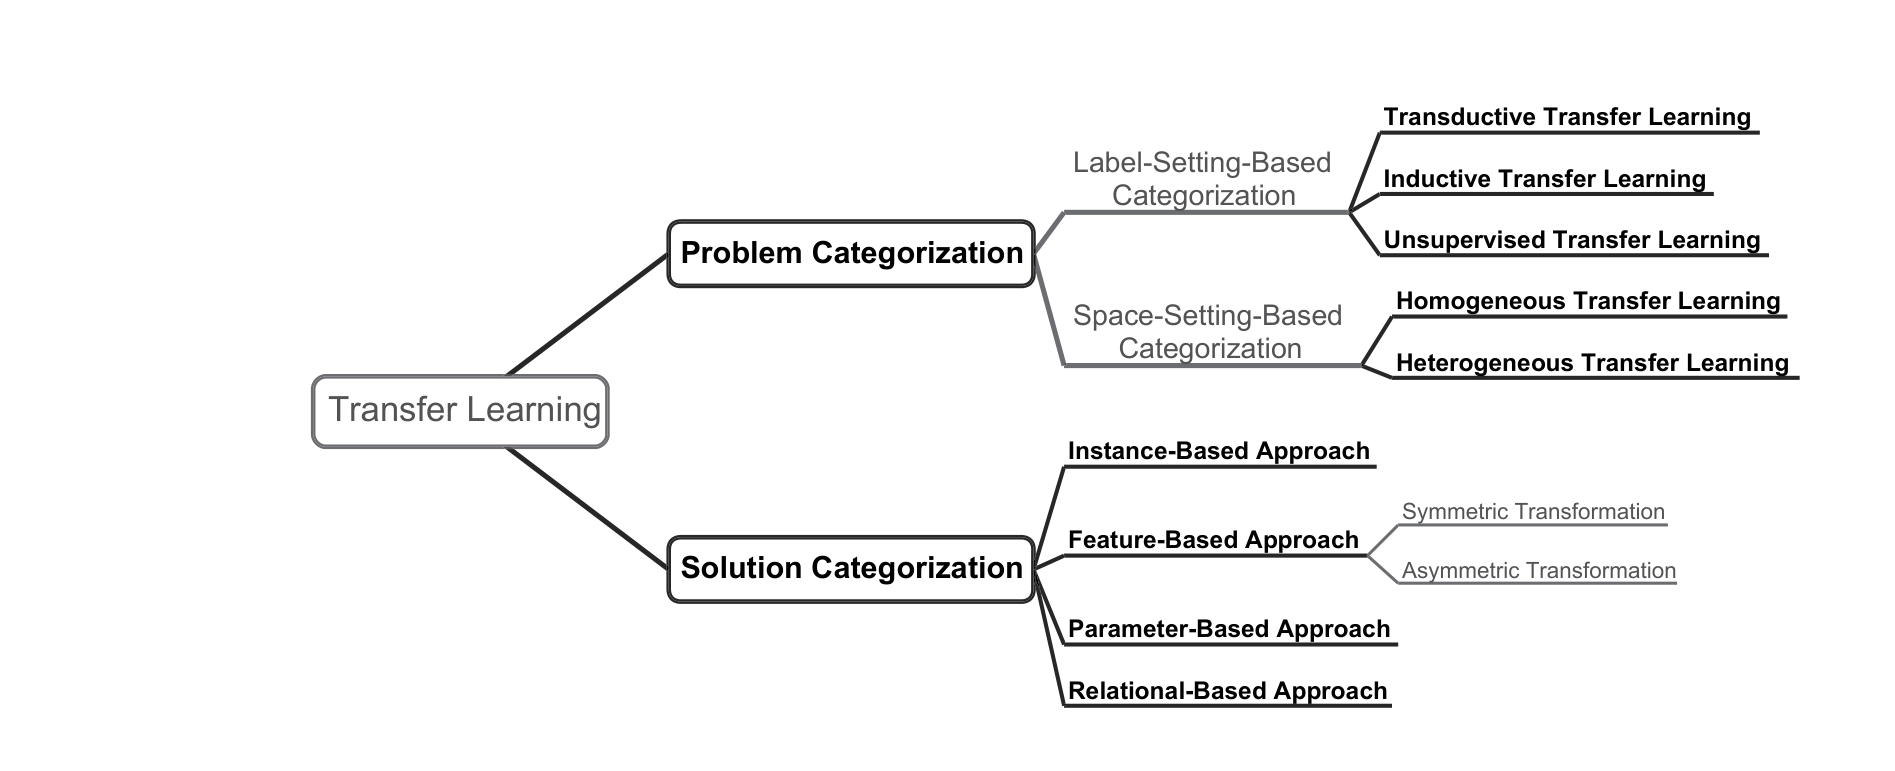
根据综述[2],迁移学习方法可分为四组:基于实例的方法、基于特征的方法、基于参数的方法和基于关系的方法。基于实例的迁移学习方法主要采用样本加权策略。基于特征的方法则对原始特征进行变换以构造新的特征表示,可进一步细分为两类,即非对称和对称的基于特征的迁移学习。非对称方法将源域特征变换以匹配目标域特征;对称方法则尝试寻找一个公共的潜在特征空间,然后将源域和目标域特征一同映射为新的特征表示。基于参数的迁移学习方法在模型或参数层面迁移知识。基于关系的迁移学习方法主要面向关系型领域的问题,将源域中学到的逻辑关系或规则迁移到目标域。为便于理解,图2给出了上述迁移学习的分类示意。
4
非对称方法将源域特征变换以匹配目标域特征;对称方法则试图寻找一个公共的潜在特征空间,再将源域和目标域特征共同映射为新的特征表示。基于参数的迁移学习方法在模型或参数层面迁移知识。基于关系的迁移学习方法则主要关注关系型领域中的问题,将源域中学习到的逻辑关系或规则迁移至目标域。为便于理解,图2给出了上述迁移学习的分类。
为帮助读者更全面地了解该领域,此处列出若干综述文献。Pan和Yang[2]的综述是开创性工作,对迁移学习进行了分类并回顾了2010年以前的研究进展;Weiss等人的综述则介绍并归纳了多种同构与异构迁移学习方法[4]。异构迁移学习在Day和Khoshgoftaar[7]的综述中得到了专门讨论。部分综述聚焦于特定主题,例如强化学习[8]、计算智能[22]和深度学习[23]、[24]。此外,还有一些综述关注具体应用场景,包括行为识别[25]、视觉分类[26]、协同推荐[27]、计算机视觉[24]和情感分析[28]。
需要指出的是,本综述的组织方式并未严格遵循上述分类。在接下来两节中,将分别从数据和模型两个视角对迁移学习方法进行解读。粗略而言,基于数据的视角涵盖了上述基于实例和基于特征的迁移学习方法,但以更宽泛的视角展开;基于模型的视角则涵盖了上述基于参数的方法。由于针对基于关系的迁移学习的研究相对较少,且代表性方法在文献[2]、[4]中已有较好的介绍,本综述不再聚焦基于关系的方法。
5
4 基于数据的解读 {#sec-4}
对边缘分布进行适配。一种直接的做法是在损失函数中对源域样本赋予权重,该加权策略基于如下方程[5]:
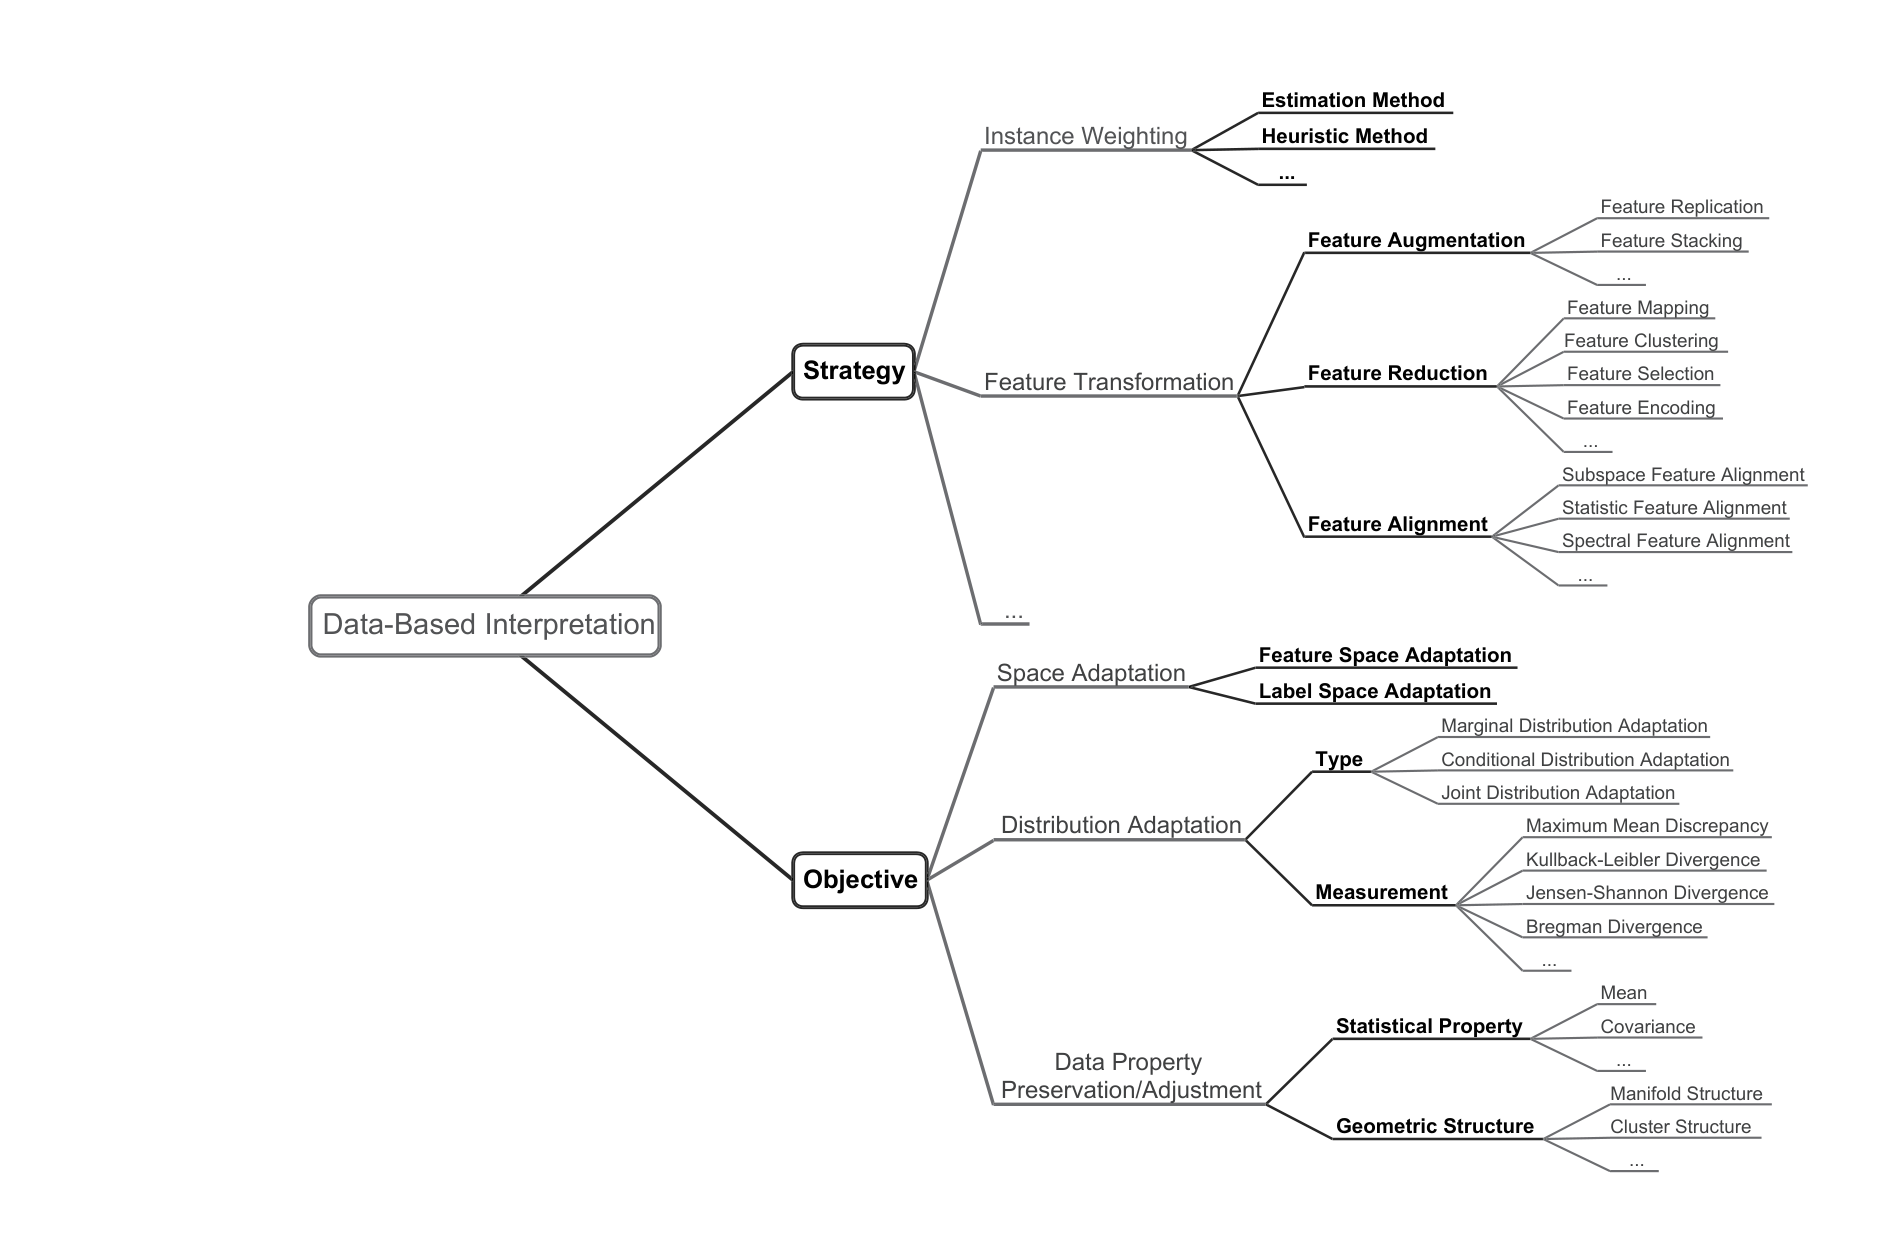
许多迁移学习方法,尤其是基于数据的方法,侧重于通过对数据的调整与变换来迁移知识。图 3 从数据角度展示了这些方法的策略与目标。如图 3 所示,空间适配是目标之一,该目标通常需要在异构迁移学习场景中满足。本综述更关注同构迁移学习,该场景下的主要目标是缩小源域与目标域实例之间的分布差异。此外,一些先进的方法还尝试在适配过程中保持数据原有的特性。从数据角度实现上述目标通常有两种策略,即实例加权和特征变换。本节将按照图 3 所示的策略顺序,依次介绍一些相关的迁移学习方法。
E(x,y)∼P T [L(x, y; f)] = E(x,y)∼P S
P S(x, y)L(x, y; f)
= E(x,y)∼P S
P S(x) L(x, y; f) .
因此,一个学习任务的总体目标函数可写为 [5]:
nS X
i=1 βiL f(xS i ), yS i + Ω(f),
min f 1
nS
其中 βi (i = 1, 2, · · · , nS) 为加权参数。βi 的理论值等于 P T (xi)/P S(xi)。然而,该比值通常是未知的,难以通过传统方法求得。Huang 等人提出的核均值匹配(Kernel Mean Matching, KMM)[5] 通过在再生核希尔伯特空间(Reproducing Kernel Hilbert Space, RKHS)中匹配源域与目标域实例的均值来解决上述未知比值的估计问题,即
4.1 实例加权策略 {#sec-4-1}
首先考虑一种简单的场景:可获得大量带标签的源域实例和有限数量的目标域实例,且两个域仅在边缘分布上存在差异(即 P S(X) ̸= P T (X) 且 P S(Y |X) = P T (Y |X))。例如,假设需要在某一特定地区(以老年人为主)构建癌症诊断模型。可用的目标域实例有限,而相关数据来自另一个以年轻人为主的地区。由于存在边缘分布差异,且老年人患癌症的风险高于年轻人,直接迁移该地区的数据可能并不成功。在这种情况下,自然会考虑
2
nS X
nT X
1
i=1 βiΦ(xS i ) −1
arg min βi∈[0,B]
j=1 Φ(xT j )
nS
nT
H
nS X
s.t. | 1
i=1 βi −1| ≤δ,
nS
其中 δ 是一个较小的参数,B 是用于约束的参数。上述优化问题可加以转化,
通过展开并运用核技巧,可将该问题转化为一个二次规划问题。这种估计分布比值的思路易于嵌入到既有算法之中。一旦获得权重 βi,即可基于加权后的源域实例训练学习器。
另有研究尝试估计权重。例如,Sugiyama 等人提出了称为 KL 重要性估计过程(Kullback-Leibler Importance Estimation Procedure,KLIEP)的方法[6]。KLIEP 以最小化 KL 散度为目标,并内建了模型选择流程。基于权重估计的相关研究,一些基于实例的迁移学习框架或算法被相继提出。例如,Sun 等人提出了一种多源框架,称为多源域自适应两阶段加权框架(2-Stage Weighting Framework for Multi-Source Domain Adaptation,2SW-MDA),包含如下两个阶段[29]。
- 实例加权:为源域实例分配权重以缩小边缘分布差异,这与 KMM 类似。
- 域加权:基于平滑性假设 [30],为每个源域分配权重以缩小条件分布差异。
随后,根据实例权重和域权重对源域实例进行重新加权。这些重加权后的实例与有标记目标域实例共同用于训练目标分类器。除了直接估计权重参数外,以迭代方式调整权重同样是有效的,其关键在于设计一种机制来降低对目标学习器产生负面影响的实例的权重。代表性工作是 TrAdaBoost [31],由 Dai 等人提出。该框架是 AdaBoost [32] 的扩展。AdaBoost 是一种面向传统机器学习任务的有效提升算法,在其每次迭代中,基于更新权重后的实例训练得到一个弱分类器。实例的加权机制确保被错误分类的实例获得更多关注,最终将所得弱分类器组合形成强分类器。TrAdaBoost 将 AdaBoost 扩展至迁移学习场景,设计了一种新的加权机制以削弱分布差异带来的影响。具体而言,在 TrAdaBoost 中,有标记的源域和目标域实例被合并构成一个统一的训练集以训练弱分类器,但对源域实例和目标域实例的加权操作有所不同。在每次迭代中,首先计算一个临时变量 $\bar{\delta}$,用于衡量在有标记目标域实例上的分类错误率;然后根据 $\bar{\delta}$ 和各自的分类结果更新目标域实例的权重,同时依据一个设定的常数和各自的分类结果更新源域实例的权重。为便于理解,第 $k$ 次($k=1,\cdots,N$)迭代中用于更新权重的公式如下 [31]:
$\beta^S_{k,i}=\beta^S_{k-1,i}\bigl(1+\sqrt{\tfrac{2\ln n_S}{N}}\bigr)^{-|f_k(x^S_i)-y^S_i|}\;(i=1,\cdots,n_S),$
$\beta^T_{k,j}=\beta^T_{k-1,j}\bigl(\bar{\delta}_k/(1-\bar{\delta}_k)\bigr)^{-|f_k(x^T_j)-y^T_j|}\;(j=1,\cdots,n_T).$
βT k,j = βT k−1,j (¯δk/(1 − ¯δk))^{−|f_k(xT j) − yT j |} (j = 1, ···, nT)。
6
需要说明的是,每次迭代都会生成一个新的弱分类器,最终分类器通过投票机制将后半部分新生成的弱分类器组合并集成而成。一些研究进一步扩展了 TrAdaBoost。Yao 和 Doretto [33] 提出了多源 TrAdaBoost(MsTrAdaBoost)算法,该算法在每次迭代中主要包含以下两个步骤。1) 候选分类器构建:在每个源域与目标域组成的实例对(即 $\mathcal{D}^S_i\cup\mathcal{D}^T$,$i=1,\cdots,m_S$)上加权实例,分别训练一组候选弱分类器。2) 实例加权:选择在目标域实例上分类错误率 $\bar{\delta}$ 最小的分类器(记为 $j$,其在 $\mathcal{D}^S_j\cup\mathcal{D}^T$ 上训练),并据此更新 $\mathcal{D}^S_j$ 与 $\mathcal{D}^T$ 中实例的权重。最终,将每次迭代所选分类器组合形成最终分类器。文献 [33] 中还提出了另一种基于参数的算法 TaskTrAdaBoost,相关介绍见第 5.3 节。一些方法以启发式方式实现实例加权策略。例如,Jiang 和 Zhai 提出了一种通用加权框架 [34],其目标函数包含三项,分别用于最小化三类实例上的交叉熵损失。构造目标分类器时使用了以下三类实例。
• 有标记目标域实例:分类器应在这些实例上最小化交叉熵损失,这实质上是一项标准的监督学习任务。
• 无标记目标域实例:这些实例的真实条件分布 $P(y|x^{T,U}_i)$ 未知,需要进行估计。一种可行的方案是在有标记源域和目标域实例上训练一个辅助分类器,以辅助估计条件分布或为这些实例赋予伪标签。
• 有标记源域实例:作者将 $x^{S,L}_i$ 的权重定义为两部分之积,即 $\alpha_i$ 与 $\beta_i$。权重 $\beta_i$ 在理想情况下等于 $P^T(x_i)/P^S(x_i)$,可通过 KMM 等非参数方法估计,或在最坏情况下取均匀值。权重 $\alpha_i$ 用于过滤掉与目标域差异较大的源域实例。$\alpha_i$ 的取值可通过一种启发式方法得到,包含以下三个步骤。1) 辅助分类器构建:利用有标记目标域实例训练一个辅助分类器,对无标记源域实例进行分类。2) 实例排序:根据概率预测结果对源域实例进行排序。3) 启发式加权($\beta_i$):将排序靠前且预测错误的 $k$ 个源域实例的权重置为零,其余实例的权重置为一。
4.2 特征变换策略 {#sec-4-2}
特征变换策略在基于特征的方法中经常被采用。例如,考虑一个跨领域文本分类问题。任务是利用来自相关领域的标注文本数据来构建目标分类器。
表 2 迁移学习中所采用的度量指标。
度量方式 相关算法
最大均值差异 [35] [36] [37] [38] [39] 等 KL 散度 [40] [41] [42] [43] [44] 等 JS 散度 [45] [46] [47] [48] [49] 等 Bregman 散度 [50] [51] [52] [53] [54] 等 Hilbert-Schmidt 独立性准则 [55] [36] [56] [57] [58] 等
在该场景下,一种可行的解决方案是通过特征变换找到共同的潜在特征(例如潜在主题),并以此作为桥梁来迁移知识。基于特征的方法将每个原始特征变换为新的特征表示,以实现知识迁移。构建新特征表示的目标包括:最小化边缘分布差异和条件分布差异,保持数据的特性或潜在结构,以及发现特征之间的对应关系。特征变换的操作可分为三种类型,即特征增强、特征降维和特征对齐。此外,特征降维还可以进一步细分为多种类型,如特征映射、特征聚类、特征选择和特征编码。在一个算法中设计的完整特征变换过程可能由多种操作组合而成。
4.2.1 分布差异度量 {#sec-4-2-1}
特征变换的一个主要目标是缩小源领域和目标领域实例的分布差异。因此,如何有效地度量领域间的分布差异或相似性是一个重要问题。 在迁移学习领域中,一种被称为最大均值差异(Maximum Mean Discrepancy, MMD)的度量方式被广泛使用,其定义如下 [35]:
2
nS ∑
nT ∑
1
i=1 Φ(xS i ) −1
j=1 Φ(xT j )
MMD(XS, XT) =
.
nS
nT
H
MMD 可以通过核技巧方便地计算。简而言之,MMD 通过在 RKHS 中计算实例均值之间的距离来量化分布差异。需要指出的是,前文提到的 KMM 实际上是通过最小化领域间的 MMD 距离来生成实例的权重。 表 2 列出了一些常用的度量指标及相关算法。除了表 2 中的指标之外,迁移学习中还采用了其他一些度量准则,包括 Wasserstein 距离 [59]、[60]、中心矩差异 [61] 等。也有部分研究致力于对已有度量方式进行优化和改进。以 MMD 为例,Gretton 等人提出了 MMD 的多核版本,即 MK-MMD [62],它利用了多个核的优势。此外,Yan 等人提出了 MMD 的加权版本 [63],试图解决类别权重偏置的问题。
7
4.2.2 特征增强 {#sec-4-2-2}
特征增强操作在特征变换中被广泛使用,尤其是在对称的基于特征的方法中。具体而言,特征增强可以通过多种方式实现,如特征复制和特征堆叠。为了便于理解,我们首先介绍一种基于特征复制的简单迁移学习方法。 Daumé 的工作提出了一种简单的领域自适应方法,即特征增强方法(Feature Augmentation Method, FAM)[64]。该方法通过简单的特征复制来变换原始特征。具体来说,在单源迁移学习场景中,特征空间被扩充为原始大小的三倍。新特征表示由通用特征、源领域特有特征和目标领域特有特征三部分组成。需要注意的是,对于变换后的源领域实例,其目标领域特有特征被设置为零;类似地,对于变换后的目标领域实例,其源领域特有特征被设置为零。FAM 的新特征表示如下:
ΦS(xS i ) = ⟨xS i , xS i , 0⟩, ΦT (xT j ) = ⟨xT j , 0, xT j ⟩,
其中,ΦS 和 ΦT 分别表示从源域和目标域到新特征空间的映射。最终分类器在变换后的有标签实例上进行训练。值得指出的是,这种数据增强方法实际上是冗余的。换言之,以其他方式(使用更少的维度)扩展特征空间同样有望取得具有竞争力的性能。FAM 的优势在于其特征扩展形式简洁优雅,由此带来若干良好性质,例如可自然推广到多源场景。Daumé 等人在 [65] 中提出了 FAM 的一种扩展,利用无标签实例进一步促进知识迁移过程。然而,FAM 在处理异构迁移学习任务时可能效果有限。原因在于,当源域与目标域的特征表示不同时,直接复制特征并补零向量的做法效果欠佳。为解决这一问题,Li 等人提出了称为异构特征增强(HFA)的方法 [66], [67]。HFA 的特征表示如下:
ΦS(x_i^S) = ⟨W^S x_i^S, x_i^S, 0^T⟩, ΦT(x_j^T) = ⟨W^T x_j^T, 0^S, x_j^T⟩,
其中 W^S x_i^S 与 W^T x_j^T 具有相同的维度;0^S
与 0^T 分别为维度与 x^S
和 x^T 相对应的零向量。HFA 将原始特征映射到一个公共特征空间,再执行特征堆叠操作,将映射后的特征、原始特征与零元素按特定顺序拼接,从而生成新的特征表示。
4.2.3 特征映射 {#sec-4-2-3}
在传统机器学习领域,已有多种可行的基于映射的特征提取方法,如主成分分析(PCA)[68] 和核主成分分析(KPCA)[69]。然而,这些方法主要关注数据方差,而非分布差异。为了解决分布差异问题,
研究者针对迁移学习提出了一些特征提取方法。首先考虑一种简单情形:各领域条件分布差异较小。此时,可采用如下简单的目标函数来求解用于特征提取的映射:
min_Φ [ DIST(X^S, X^T; Φ) + λ Ω(Φ) ] / [ VAR(X^S ∪ X^T; Φ) ],
其中 Φ 为低维映射函数,DIST(·) 表示分布差异度量,Ω(Φ) 为控制 Φ 复杂度的正则项,VAR(·) 表示实例的方差。该目标函数的目的是寻找一个映射函数 Φ,使领域间的边缘分布差异最小化,同时使实例的方差尽可能大。分母所对应的目标可通过多种方式优化。一种可行做法是在方差约束下优化分子目标,例如可将映射后实例的散度矩阵约束为单位矩阵。另一种做法是先在高维特征空间中优化分子目标,再借助 PCA 或 KPCA 等降维算法实现分母的目标。进一步地,求解 Φ(·) 的显式形式并非易事。为此,一些方法采用线性映射技术,或转而借助核技巧。总体而言,处理上述优化问题主要有三种思路。
•(映射学习 + 特征提取)一种可行做法是首先寻找一个高维空间,通过求解核矩阵学习问题或变换矩阵求解问题来满足目标,再将高维特征压缩以形成低维特征表示。例如,在习得核矩阵之后,可基于 PCA 提取隐式高维特征的主成分,从而构造新的特征表示。
•(映射构造 + 映射学习)另一种做法是将原始特征映射到一个构造出的高维特征空间,再学习一个低维映射以满足目标函数。例如,可先基于选定的核函数构造核矩阵,随后学习变换矩阵,将高维特征投影到公共潜在子空间。
•(直接低维映射学习)直接寻找理想的低维映射通常较为困难。然而,若假设该映射满足某些条件,则问题有望可解。例如,若将低维映射限制为线性映射,则优化问题便可容易求解。 部分方法还试图在匹配条件分布的同时保留数据结构。为实现这一目标,上述简单的目标函数需要引入新的项或(以及)约束。例如,可采用如下一般性目标函数:
min Φ µDIST(XS, XT ; Φ) + λ1ΩGEO(Φ) + λ2Ω(Φ)
- (1 −µ)DIST(Y S|XS, Y T |XT ; Φ),
s.t. Φ(X)THΦ(X) = I, with H = I −(1/n) ∈Rn×n,
8
其中 µ 是用于权衡边缘分布差异与条件分布差异[70]的参数,ΩGEO(Φ) 是控制几何结构的正则项,Φ(X) 是由来自源域和目标域的实例(采用所提取的新特征表示)按行构成的矩阵,H 是用于构造散度矩阵的 centering 矩阵,约束条件用于最大化方差。目标函数中的最后一项用于衡量条件分布差异。 在进一步讨论上述目标函数之前,有必要指出,目标域实例的标签信息往往十分有限甚至完全未知。标签信息的匮乏使得分布差异难以估计。为解决这一问题,部分方法采用伪标签策略,即为未标记的目标域实例赋予伪标签。一种简单的实现方式是训练一个基础分类器来分配伪标签。此外,还有其他一些伪标签生成方法,如协同训练[71]、[72]以及三体训练[73]、[74]。一旦补齐了伪标签信息,便可对条件分布差异进行度量。例如,可以将 MMD 进行修改与扩展以衡量条件分布差异。具体而言,针对每个类别,分别汇集源域与目标域中属于同一类的实例,条件分布差异的估计式如下[38]:
2
nS k X
nT k X
|Y| X
1
i=1 Φ(xS i ) −1
j=1 Φ(xT j )
,
nS k
nT k
k=1
H
其中 nS k 与 nT k 分别表示源域和目标域中具有相同标签 Yk 的实例数量。该估计实际上通过度量类条件分布(即 P(x|y))的差异来近似条件分布(即 P(y|x))的差异。 部分研究对上述估计进行了改进。例如,Wang 等人采用加权方法来进一步缓解类不平衡问题[70]。为便于理解,下面详细列出作为前述一般目标函数特例的迁移学习方法。
•(µ = 1 且 λ1 ≠ 0)最大均值差异嵌入(MMDE)的目标函数如下[75]:
nS + nT X
min K MMD(XS, XT ; Φ) − λ1
i̸=j ||Φ(xi) −Φ(xj)||2
s.t. ∀(xi ∈k-NN(xj)) ∧(xj ∈k-NN(xi)),
||Φ(xi) −Φ(xj)||2 = ||xi −xj||2, (xi, xj ∈XS ∪XT ),
其中 k-NN(x) 表示实例 x 的 k 近邻。作者受最大方差展开(MVU)[76]的启发设计了上述目标函数。该目标函数并未采用散度矩阵约束,而是通过约束条件和第二项在最大化实例间距离的同时保留局部几何结构。所期望的核矩阵 K 可通过求解半定规划(SDP)[77]问题获得。在得到核矩阵后,
对其施加 PCA,并选取主要特征向量来构建低维特征表示。
• (µ = 1 且 λ1 = 0) Pan 等人提出了一种称为迁移成分分析(TCA)的方法 [36]、[78]。TCA 采用 MMD 来度量边缘分布差异,并以散布矩阵作为约束。与 MMDE 先学习核矩阵再进行 PCA 不同,TCA 是一个统一的方法,只需从经验核特征空间学习到低维特征空间的线性映射即可,从而避免了求解 SDP 问题,计算开销相对较低。最终的优化问题可通过特征分解方便地求解。TCA 还可以扩展以利用标签信息:在扩展版本中,散布矩阵约束被替换为一个新的约束,以平衡标签依赖性(通过 HSIC 度量)与数据方差。此外,还加入了图拉普拉斯正则项 [30] 以保持流形的几何结构。类似地,最终的优化问题同样可通过特征分解求解。
• (µ = 0.5 且 λ1 = 0) Long 等人提出了一种称为联合分布适配(JDA)的方法 [38]。JDA 试图寻找一个变换矩阵,将样本映射到一个低维空间,在该空间中同时最小化边缘分布差异和条件分布差异。为此,JDA 采用 MMD 度量和伪标签策略。所求的变换矩阵可通过特征分解求解一个迹优化问题得到。进一步,伪标签的估计精度显然会影响 JDA 的性能。为了提升标注质量,作者采用了迭代求精策略。具体而言,在每次迭代中,先执行 JDA,然后在新提取的特征上训练一个分类器,再依据训练好的分类器更新伪标签,随后使用更新后的伪标签再次执行 JDA,迭代直至收敛。值得注意的是,JDA 还可以通过引入标签与结构信息 [79]、聚类信息 [80]、多种统计与几何信息 [81] 等进行扩展。
• (µ ∈ (0, 1) 且 λ1 = 0) Wang 等人提出了一种称为平衡分布适配(BDA)的方法 [70],它是 JDA 的扩展。与 JDA 假设边缘分布和条件分布在适配中同等重要不同,BDA 试图平衡两者的重要性。BDA 的整体流程与 JDA 类似。此外,作者还提出了加权版本的 WBDA。在 WBDA 中,条件分布差异通过 MMD 的加权版本来度量,以缓解类别不平衡问题。
值得一提的是,一些方法将特征变换到一个新的特征空间(通常具有较高维度),并同时训练一个自适应分类器。为实现这一目标,需要将特征的映射函数与分类器的决策函数进行关联。一种可行的方式是定义如下决策函数:
9
f(x) = θ·Φ(x)+b,其中 θ 表示分类器参数,b 表示偏置。根据表示定理 [82],参数 θ 可定义为 θ = Pn i=1 αiΦ(xi),于是可得
n X
n X
i=1 αiκ(xi, x) + b,
i=1 αiΦ(xi) · Φ(x) + b =
f(x) =
其中 κ 表示核函数。通过以核矩阵为桥梁,为映射函数设计的正则项可以被纳入分类器的目标函数中。如此一来,最终的优化问题通常仅涉及参数(例如 αi)或核函数本身。例如,Long 等人提出了一个称为基于自适应正则化的迁移学习(ARTL)的通用框架 [39]。ARTL 的目标包括:学习自适应分类器、最小化结构风险、联合减小边际分布差异与条件分布差异,以及最大化数据结构与预测结构之间的流形一致性。作者还在该框架下基于不同的损失函数提出了两种具体算法。在这两种算法中,首先构造用于计算 MMD 的系数矩阵和用于流形正则化的图拉普拉斯矩阵;随后选定核函数以构造核矩阵;接着将分类器学习问题转化为参数(即 αi)的求解问题,其求解公式亦在文献 [39] 中给出。 在 ARTL 中,核函数的选择会影响最终分类器的性能。为了构造稳健的分类器,一些研究转向核学习。例如,Duan 等人提出了一个称为领域迁移多核学习(DTMKL)的统一框架 [83]。在 DTMKL 中,核函数被假设为一组基核的线性组合,即 κ(xi, xj) = Σk=1^N βk κk(xi, xj)。DTMKL 的目标是同时最小化分布差异与分类误差等。DTMKL 的一般目标函数可以写为如下形式:
min_{βk, f} σ( MMD(X^S, X^T ; κ) ) + λ Ω_L(βk, f),
其中 σ 为任意单调递增函数,f 为决策函数,其定义与 ARTL 中的相同,Ω_L(βk, f) 是一个通用项,表示在有标签实例上定义的一组正则项,例如用于最小化分类误差和控制所得模型复杂度的正则项。作者通过使用约简梯度下降法 [84] 开发了一种同时学习核函数和决策函数的算法。在每一次迭代中,首先固定基核的权重系数以更新决策函数;然后固定决策函数以更新权重系数。需要注意的是,DTMKL 能够纳入许多现有的核方法。作者在该框架下提出了两种具体算法:第一种算法通过使用 hinge 损失和支持向量机(SVM)来实现该框架;第二种算法是第一种算法的扩展,增加了一个利用伪标签信息的正则项,其中无标签实例的伪标签由基分类器生成。
10
4.2.4 特征聚类 {#sec-4-2-4}
特征聚类旨在寻找原始特征更为抽象的特征表示方式。虽然可以将其视为一种特征提取方法,但它不同于上文所述的基于映射的特征提取方式。例如,一些迁移学习方法通过协同聚类技术隐式地实现特征约简,即基于信息论对列联表的行和列同时进行聚类(即协同聚类)[85]。Dai 等人[41]提出了一种称为基于协同聚类的分类(Co-Clustering Based Classification, CoCC)的算法,用于文档分类。在文档分类问题中,迁移学习任务的目标是利用已标注的源域文档—词数据来对目标域文档(由文档—词矩阵表示)进行分类。CoCC 将协同聚类技术作为知识迁移的桥梁:在 CoCC 算法中,源域和目标域的文档—词矩阵均进行协同聚类,源域文档—词矩阵的协同聚类在已知标注信息的指导下生成词簇,这些词簇在目标域数据的协同聚类过程中作为约束条件加以使用。协同聚类的准则在于最小化互信息损失,聚类结果通过迭代获得,每一次迭代包含以下两个步骤:1)文档聚类:根据目标函数对目标域文档—词矩阵的每一行重新排序,以更新文档簇;2)词聚类:对词簇进行调整,以最小化源域和目标域文档—词矩阵的联合互信息损失。经过若干次迭代后,算法收敛,即可得到分类结果。需要注意的是,在 CoCC 中,词聚类过程隐式地提取了词特征,并形成统一的词簇。Dai 等人还提出了一种无监督的聚类方法,称为自学习聚类(Self-Taught Clustering, STC)[42]。与 CoCC 类似,该算法同样基于协同聚类,但 STC 不需要标注信息。STC 的目标是同时对源域和目标域实例进行协同聚类,其假设两个领域在其公共特征空间中共享相同的特征簇。为此,两个协同聚类任务被同时独立地执行,以寻找共享的特征簇。STC 的每一次迭代包含以下步骤:1)实例聚类:分别更新源域和目标域实例的聚类结果,以最小化各自互信息损失;2)特征聚类:更新特征簇,以最小化联合互信息损失。当算法收敛时,即可得到目标域实例的聚类结果。与上述基于协同聚类的方法不同,还有一些方法将原始特征抽取为概念(或主题)。在文档分类问题中,这些概念体现了词语的高层抽象(例如词簇)。为便于介绍基于概念的迁移学习方法,下面简要回顾
潜在语义分析(LSA)[86]、概率潜在语义分析(PLSA)[87]以及对偶概率潜在语义分析(Dual-PLSA)[88]。
• LSA:LSA 是一种基于奇异值分解(SVD)技术将文档—词矩阵映射到低维空间(即潜在语义空间)的方法。简而言之,LSA 试图挖掘词语的真正语义。为实现这一目标,SVD 技术被用于降低维度,从而去除原始数据中的无关信息并滤除噪声信息。
• PLSA:PLSA 基于对 LSA 的统计观点发展而来。PLSA 假设存在一个潜在类别变量 z,表示将文档 d 和词 w 关联在一起的概念,并且 d 和 w 在给定概念 z 的条件下相互独立。该图模型的描述如下:
P(z_k)
d ←−−−−− P(d_i | z_k)
其中下标 i、j、k 分别表示文档、词语和概念的索引。PLSA 构建了一个贝叶斯网络,其参数通过期望最大化(Expectation-Maximization, EM)算法[89]进行估计。
• Dual-PLSA:Dual-PLSA 是 PLSA 的一种扩展。该方法假设存在两个潜在变量 z_d 和 z_w,分别用于关联文档和词语;具体而言,z_d 和 z_w 分别反映了文档和词语背后的概念。Dual-PLSA 的图模型描述如下:
d
Dual-PLSA 的参数同样可由 EM 算法求得。一些基于概念(concept-based)的迁移学习方法以 PLSA 为基础构建。例如,Xue 等人提出了称为主题桥接概率潜在语义分析(Topic-Bridged Probabilistic Latent Semantic Analysis,TPLSA)的跨域文本分类方法 [90]。TPLSA 是 PLSA 的一种扩展,它假设源域和目标域的实例共享相同的词语混合概念。该方法不再分别对源域和目标域各做一次 PLSA,而是以混合概念 z 为桥梁,将两个 PLSA 合并为一个统一的模型,即每个概念都具有一定的概率同时生成源域和目标域文档。TPLSA 的图模型如下所示:
dS
dT ⇓ P (dS_i | z_k) ======= P (dT_i | z_k) z P (z_k | w_j) ←−−−−−−w.
需要注意的是,PLSA 本身并不需要标签信息。为了利用标签信息,作者在 TPLSA 的目标函数中加入了概念约束作为惩罚项,这些约束包括 must-link 约束和 cannot-link 约束。最终的目标函数通过 EM 算法迭代优化,从而获得分类结果(即 arg max_z P(z | dT_i))。 Zhuang 等人提出了称为协同 Dual-PLSA(Collaborative Dual-PLSA,CD-PLSA)的方法,用于多域文本分类(共 mS 个源域和 mT 个目标域)
[91], [92]。CD-PLSA 是 Dual-PLSA 的一种扩展,其图模型如下所示:
P (d_i | z^d_{k_1}, D_{k_0})
P (D_{k_0}) ⇓ D →
P (w_j | z^w_{k_2}, D_{k_0})
⇓ d ←z^d P (z^d_{k_1}, z^w_{k_2}) z^w →
⇓ w ⇣
⇡,
其中 1 ≤ k_0 ≤ mS + mT 表示域的索引。域 D 同时连接变量 d 和 w,但与变量 z^d 和 z^w 相互独立。源域实例的标签信息通过初始化 P(d_i | z^d_{k_1}, D_{k_0})(k_0 = 1, · · · , mS)的取值加以利用。由于缺少目标域的标签信息,P(d_i | z^d_{k_1}, D_{k_0})(k_0 = mS + 1, · · · , mS + mT)可基于任意有监督分类器进行初始化。类似地,作者采用 EM 算法来求解参数;通过迭代,可获得贝叶斯网络中的所有参数。因此,目标域 D_k 中第 i 篇文档的类别标签可通过计算后验概率 arg max_{z^d} P(z^d | d_i, D_k) 来预测。 Zhuang 等人进一步提出了一个称为同构—相同—相异概念模型(Homogeneous-Identical-Distinct-Concept Model,HIDC)的通用框架 [93]。该框架同样是 Dual-PLSA 的一种扩展,由 identical-concept、homogeneous-concept 和 distinct-concept 三种生成模型组成。这三种图模型分别如下所示:
一致概念模型: D → d ← z^d ⇣
⇡ → z^w IC → w,
⇣ D → d ← z^d ⇣
齐次概念模型:
→ z^w HC → w,
⇣
⇣ D → d ← z^d ⇣
Distinct-Concept Model(不同概念模型):
⇡ → z^w DC → w .
原始的词语概念 z^w 被划分为 z^w_IC、z^w_HC 和 z^w_DC 三类。在 identical-concept 模型中,词语分布仅依赖于词语概念,且词语概念与域无关;而在 homogeneous-concept 模型中,词语分布还依赖于具体的域。两者的区别在于:z^w_IC 是可直接迁移的,而 z^w_HC 则是与域相关的可迁移概念,对不同域的词语分布可能产生不同的影响。在 distinct-concept 模型中,z^w_DC 实际上是域专有且不可迁移的概念,仅在特定域中出现。上述三种模型被整合为一个统一的模型,即 HIDC。与其他 PLSA 相关算法类似,HIDC 也采用 EM 算法求解参数。
4.2.5 特征选择 {#sec-4-2-5}
特征选择是另一种特征约简操作,用于抽取枢纽特征(pivot features)。枢纽特征是在不同域中表现一致的特征。由于这些特征具有较强的稳定性,因而可作为桥梁实现知识迁移。例如,Blitzer 等人提出了一种称为
11
结构对应学习(Structural Correspondence Learning,SCL)[94]。简言之,SCL 通过以下步骤构造新的特征表示。 1. 特征选择:SCL 首先进行特征选择操作,以获得枢轴特征。 2. 映射学习:利用枢轴特征,通过结构学习技术 [95] 寻找一个低维的公共潜在特征空间。 3. 特征堆叠:通过特征增强(即在原始特征上堆叠所得到的低维特征)构造新的特征表示。 以词性标注问题为例,所选枢轴特征应在源域和目标域中频繁出现。因此,限定词可以纳入枢轴特征。一旦所有枢轴特征被定义并选出,便构造若干二元线性分类器,其作用是预测每个枢轴特征的出现。在不失一般性的情况下,用于预测第 i 个枢轴特征的决策函数可表述为 fi(x) = sign(θi·x),其中 x 被假定为二元特征输入。第 i 个分类器在除由第 i 个枢轴特征衍生的特征之外的所有实例上进行训练。可使用下式估计第 i 个分类器的参数,即
n
1
j=1 L (θ · xj, Rowi(xj)) + λ||θ||2,
θi = arg min θ
n
其中 Rowi(xj) 表示无标注实例 xj 在第 i 个枢轴特征上的真实值。通过将所得参数向量按列元素堆叠,可得到矩阵 ˜W。接下来,基于奇异值分解(SVD),取矩阵 ˜W 的前 k 个左奇异向量(即主成分)来构造变换矩阵 W。最后,在增广特征空间(即 ([xL i ; W TxL i ]T, yL i ))上的有标注实例上训练最终分类器。
4.2.6 特征编码 {#sec-4-2-6}
除特征提取和特征选择外,特征编码也是一种有效手段。例如,深度学习领域常用的自编码器便可用于特征编码。自编码器由编码器和解码器组成:编码器试图生成输入的更抽象表示,而解码器则旨在将该表示映射回去并最小化重构误差。自编码器可以堆叠起来构建深度学习架构。当一个自编码器完成训练后,可在它的顶部再堆叠另一个自编码器,并将上层自编码器的编码输出作为其输入来训练新加入的自编码器,由此即可构建深度学习架构。 一些迁移学习方法正是基于自编码器开发的。例如,Glorot 等人提出了一种称为堆叠去噪自编码器(Stacked Denoising Autoencoder,SDA)的方法 [96]。去噪自编码器可增强鲁棒性,是基本自编码器的一种扩展 [97]。此类自编码器包含一种随机加噪机制,会在映射之前向输入添加噪声。例如,可以通过添加掩蔽噪声或高斯噪声使输入被损坏或部分破坏。随后,去噪自编码器通过训练以最小化原始干净输入与输出之间的去噪重构误差。文中所提出的 SDA 算法主要包括以下步骤。 1. 自编码器训练:利用源域和目标域的实例,以逐层贪婪的方式训练一组堆叠的去噪自编码器。 2. 特征编码与堆叠:通过堆叠中间层的编码输出构造新的特征表示,并将实例的特征变换到所得的新表示中。 3. 学习器训练:在变换后的有标注实例上训练目标分类器。
尽管 SDA 算法在特征提取方面表现出色,但仍存在一些不足,例如计算开销和参数估计成本较高。为了缩短训练时间、加速传统 SDA 算法,Chen 等人提出了 SDA 的改进版本,即边缘化堆叠线性去噪自编码器(Marginalized Stacked Linear Denoising Autoencoder,mSLDA)[98]、[99]。该算法采用线性自编码器,并以闭式形式边缘化随机加噪步骤。线性自编码器看似过于简单而难以学习复杂特征,但作者观察到在面对高维数据时,线性自编码器通常足以获得具有竞争力的性能。mSLDA 的基本架构是一个单层线性自编码器。其对应的单层映射矩阵 W(为方便起见附加一列偏置)应最小化期望平方重构损失函数,即
n
i=1 EP (˜xi|x) ||xi −W ˜xi||2,
1
W = arg min W
2n
其中 ˜xi 表示输入 xi 的受扰动版本。W 的解由 [98]、[99] 给出:
n X
i=1 xiE[˜xi]T ! n X
i=1 E h ˜xi˜xT i i!−1
W =
当确定扰动策略后,上述公式可进一步展开并化简为具体形式。需要注意的是,为了引入非线性,在以闭式求得矩阵 W 之后,会使用一个非线性函数对每个自编码器的输出进行压缩。然后,以与 SDA 类似的方式将下一个线性自编码器堆叠到当前自编码器之上。为了应对高维数据,作者还提出了一种扩展方法以进一步降低计算复杂度。
4.2.7 特征对齐 {#sec-4-2-7}
需要指出的是,特征增强与特征降维主要关注特征空间中的显式特征。相比之下,特征对齐除关注显式特征外,还关注一些隐式特征,例如统计特征和频谱特征。因此,特征对齐在特征变换过程中能够发挥多种作用。例如,可以对显式特征进行对齐以生成新的特征表示,或者
12
也可以对隐式特征进行对齐以构建满足需求的特征变换。 可对齐的特征种类较多,包括子空间特征、频谱特征和统计特征。以子空间特征对齐为例,一种典型方法通常包含以下步骤。
- 子空间生成:在该步骤中,利用实例分别为源域和目标域生成相应的子空间,然后分别获得源域和目标域子空间的正交基,记为 MS 和 MT。这些基用于学习子空间之间的偏移。
- 子空间对齐:在第二步中,学习一个将子空间基 MS 与 MT 对齐的映射,并将实例的特征投影到对齐后的子空间中以生成新的特征表示。
- 学习器训练:最后,在变换后的实例上训练目标学习器。
例如,Fernando 等人的工作提出了一种称为子空间对齐(Subspace Alignment, SA)的方法 [100]。在 SA 中,子空间通过执行 PCA 生成;基 MS 和 MT 通过选取前导特征向量得到。随后,学习一个变换矩阵 W 来对齐子空间,其形式如下 [100]:
W = arg min\limits_{W} |MSW − M^{T}|_{F}^{2} = M^{T}S M^{T},
其中 || · ||F 表示 Frobenius 范数。需要注意的是,矩阵 W 将 MS 与 MT 对齐,或者说将源子空间坐标系变换到目标子空间坐标系。变换后的低维源域和目标域实例分别由 XSMSW 和 XT MT 给出。最后,可以在得到的变换后实例上训练学习器。 受 SA 启发,已涌现出多种迁移学习方法。例如,Sun 和 Saenko 的论文提出了一种同时对齐子空间基与分布的方法 [101],称为双子空间子空间分布对齐(Subspace Distribution Alignment between Two Subspaces, SDA-TS)。在 SDA-TS 中,变换矩阵 W 被表述为 W = M T SMT Q,其中 Q 是用于对齐分布差异的矩阵。当 Q 设为单位矩阵时,SA 中的变换矩阵 W 即为 SDA-TS 的一个特例。需要说明的是,SA 是一种对称的基于特征的方法,而 SDA-TS 则是一种非对称方法。在 SDA-TS 中,有标签的源域实例先被投影到源子空间,再映射到目标子空间,最后被映射回目标域。变换后的源域实例表述为 XSMSWM T T 。 另一类具有代表性的子空间特征对齐方法是测地线流核(Geodesic Flow Kernel, GFK)[102],由 Gong 等人提出。GFK 与此前提出的测地线流子空间(Geodesic Flow Subspaces, GFS)方法 [103] 密切相关。在介绍 GFK 之前,先回顾 GFS 的步骤。GFS 的灵感来源于增量学习。直观上,利用两个域之间潜在路径所传递的信息可能有助于领域自适应。GFS 通常通过以下步骤进行特征对齐。
- 子空间生成:GFS 首先通过分别执行 PCA 生成源域和目标域的两个子空间。
- 子空间插值:将所得到的两个子空间视为 Grassmann 流形 [104] 上的两个点,基于该流形的几何性质,在这两个子空间之间生成有限数量的插值子空间。
- 特征投影与堆叠:通过堆叠来自所有已得到子空间的对应投影,对原始特征进行变换。
尽管GFS具有实用性与优越性,但如何确定插值子空间的数量仍是一个问题。GFK通过对从源子空间到目标子空间沿测地线分布的无数子空间进行积分来解决这一问题。GFK的核心在于构建一个包含测地流上所有子空间信息的无穷维特征空间。为了在该无穷维空间中计算内积,定义并推导了测地流核。此外,还提出了一种子空间不一致性度量以选择子空间的最优维度;在多个源域可用的情况下,还提出了一种域秩度量以选择最优源域。 统计特征对齐是另一类特征对齐方法。例如,Sun等人提出了一种称为协方差对齐(CORAL)的方法[105]。CORAL通过对二阶统计特征(即协方差矩阵)进行对齐来构建源特征的变换矩阵。变换矩阵W由下式给出[105]: W = arg min W ||W^TC_SW − C_T||^2_F,
其中C表示协方差矩阵。需要注意的是,与上述基于子空间的方法相比,CORAL无需进行子空间生成与投影,因而易于实现。 部分迁移学习方法基于谱特征对齐构建。在传统机器学习领域,谱聚类是一种基于图论的聚类技术。其核心在于利用相似度矩阵的谱(即特征值)在聚类之前对特征进行降维。相似度矩阵用以定量评估每一对数据/顶点之间的相对相似度。在谱聚类与特征对齐的基础上,Pan等人提出了谱特征对齐(SFA)[106]。SFA是一种用于情感分类的算法,该算法试图在不同领域中识别领域专属词与领域无关词,随后对这些领域专属词的特征进行对齐,以构建低维特征表示。SFA通常包含以下五个步骤。
- 特征选择:在该步骤中,通过执行特征选择操作来挑选领域无关/枢纽特征。论文给出了三种用于选择领域无关特征的策略,这些策略分别基于词的出现频率、特征与
13
标签[107],以及特征与领域之间的互信息。2. 相似度矩阵构建:在识别出领域特有特征和领域无关特征后,构建二部图,并为该二部图中的每条边赋予权重,用以度量领域特有词与领域无关词之间的共现关系。在此基础上,进一步构建相似度矩阵。3. 谱特征对齐:在该步骤中,采用并执行谱聚类算法以对齐领域特有特征[108]、[109]。具体而言,基于图拉普拉斯矩阵的特征向量构建特征对齐映射,并将领域特有特征映射到低维特征空间。4. 特征堆叠:将原始特征与低维特征进行堆叠以生成最终的特征表示。5. 学习器训练:利用最终的特征表示在已标记实例上训练目标学习器。还有一些其他的谱迁移学习方法。例如,文献[110]提出了一种称为跨域谱分类器(CDSC)的方法。该方法的主要思路与步骤如下。1. 相似度矩阵构建:在第一步中,分别针对全部实例和目标域实例构建两个相似度矩阵。2. 谱特征对齐:针对图划分指示向量设计目标函数,并构造包含成对必连信息的约束矩阵;不再寻求指示向量的离散解,而是将其松弛为连续形式,求解与目标函数对应的特征值问题以构建对齐后的谱特征[111]。3. 学习器训练:在变换后的实例上训练传统的分类器。具体而言,目标函数具有广义瑞利商的形式,旨在寻找既尊重标记信息且具有较小割大小的最优图划分[112],以最大化目标域实例之间的可分性,并满足成对性质的约束。在特征分解之后,选取最后的若干特征向量组合成矩阵,再对该矩阵进行归一化,归一化后矩阵的每一行即表示一个变换后的实例。
5 基于模型的解读 {#sec-5}
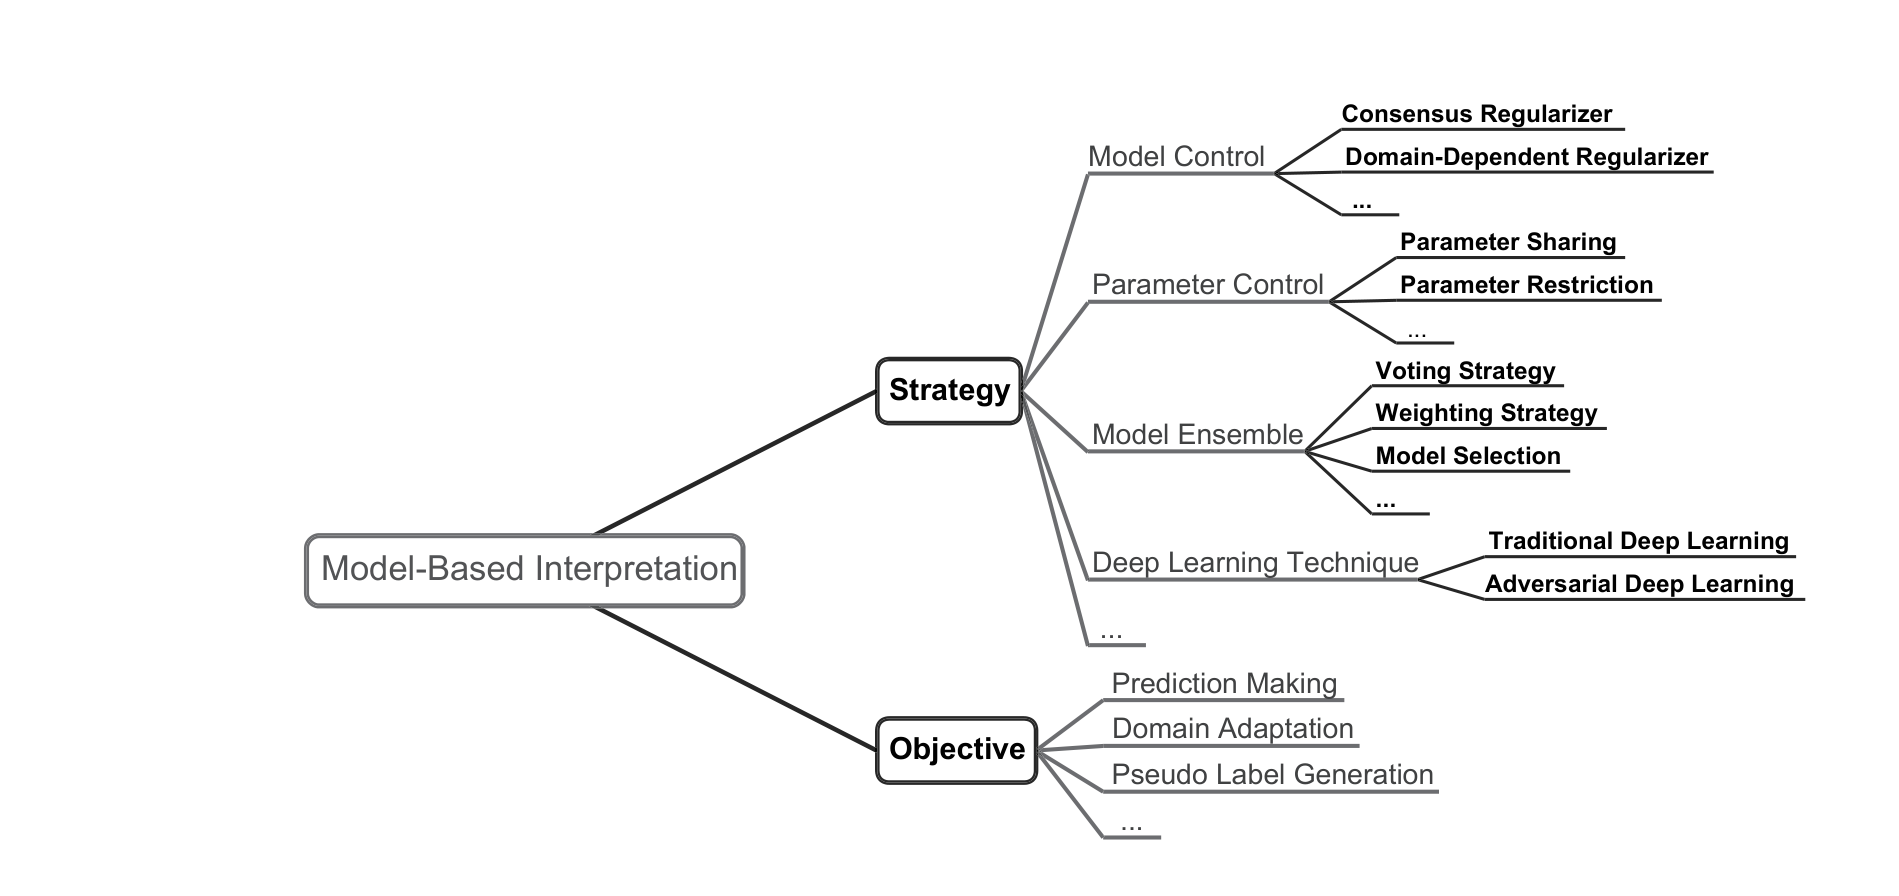
迁移学习方法也可以从模型角度加以解读。图4展示了相应的策略与目标。迁移学习模型的主要目标是对目标域产生准确的预测结果,例如分类或聚类结果。需要注意的是,一个迁移学习模型可能由若干子模块构成,如分类器、提取器或编码器等。这些子模块可以承担不同的角色,例如特征适配或伪标签生成。本节将按照图4所示的策略顺序介绍一些相关的
14
(其中 k = 1, · · · , mS)与 DAM 中的目标函数类似,具体如下:
迁移学习方法应根据图 4 所示的策略按适当顺序介绍。
∑
\n_{i=1} ^{n_k^S} \log P(y_i^{S_k} |x_i^{S_k}; f_k^{S}) + \lambda_2 \Omega(f_k^{S})
\min_{f_k^{S}}
5.1 模型控制策略 {#sec-5-1}
∑
∑
y_j \in Y^S \left( 1 -
∑
_{k'=1} ^{m_S} P(y_j |x_i^{T,U}; f_{k'}^{S}) \right),
- \lambda_1
从模型的角度来看,一个直观的想法是将模型层面的正则项直接加入学习器的目标函数中。通过这种方式,先前获得的源模型中所蕴含的知识便可在训练过程中迁移到目标模型。例如,文献[113]、[114]提出了一个面向多源迁移学习的通用框架,称为域适应机(DAM)。DAM 的目标是借助若干分别在多个源域上预先训练好的基础分类器,为目标域构建一个鲁棒的分类器。其目标函数为:
_{i=1}^{n^{T,U}}
m_S
其中 f_k^S 表示第 k 个源域对应的决策函数,S(x) = -x \log x。第一项用于量化第 k 个分类器在第 k 个源域上的分类误差,最后一项是采用交叉熵形式的一致性正则项。该一致性正则项不仅能够增强所有分类器之间的一致性,还可以降低目标域上预测结果的不确定性。作者基于逻辑回归实现了该框架。DAM 与 CRF 之间的一个区别在于:DAM 显式地构造目标分类器,而 CRF 则基于源分类器所达成的一致性来给出目标预测结果。
\min_{f^T} L^{T,L}(f^T) + \lambda_1 \Omega_D(f^T) + \lambda_2 \Omega(f^T),
•(领域依赖正则项)Fast-DAM 是 DAM [113] 的一种具体算法。借鉴流形假设 [30] 和基于图的正则项 [117]、[118],Fast-DAM 设计了一种领域依赖的正则项。其目标函数为:
其中第一项表示用于最小化有标记目标域实例分类误差的损失函数,第二项表示不同的正则项,第三项用于控制最终决策函数 f_T 的复杂度。在 L_{T,L}(f_T) 中可采用不同类型的损失函数,如平方误差或交叉熵损失。某些迁移学习方法在一定程度上可视为该框架的特殊情形。
∑{j=1}^{n{T,L}}
(f_T(x_{j}^{T,L}) − y_{j}^{T,L})^2 + λ_2 Ω(f_T)
min_{f_T}
j=1
∑_{k=1}^{m_S} β_k
∑{i=1}^{n{T,U}}
(f_T(x_i^{T,U}) − f_k^S(x_i^{T,U}))^2
+λ_1
k=1
i=1
•(一致性正则项)Luo 等人提出了一种称为一致性正则框架(CRF)的框架 [115]、[116]。CRF 面向无标记目标域实例的多源迁移学习。该框架为每个源域构建 m_S 个分类器,并要求这些分类器在目标域上达成相互一致。各源分类器的目标函数记为 f_k^S
其中 f_k^S(k = 1, 2, ··· , m_S)表示第 k 个源域的预训练源决策函数,β_k 表示权重参数,由目标域与第 k 个源域之间的相关性确定,可基于 MMD 指标进行度量。第三项为领域依赖正则项,用于在领域依赖性的驱动下迁移
源分类器中所蕴含的知识。在文献 [113] 中,作者还基于 ε-不敏感损失函数 [119] 在上述目标函数中引入并添加了一项新项,使所得模型具有较高的计算效率。
•(领域依赖正则项 + Universum 正则项)Univer-DAM 是 Fast-DAM [114] 的扩展。其目标函数包含一个额外的正则项,即 Universum 正则项。该正则项通常利用一个称为 Universum 的额外数据集,其中的实例既不属于正类也不属于负类 [120]。作者将源域实例视为目标域的 Universum,Univer-DAM 的目标函数如下所示:
∑{j=1}^{n{T,L}}
∑_{j=1}^{n_S}
(f_T(x_j^{T,L}) − y_j^{T,L})^2 + λ_2
(f_T(x_j^S))^2
min_{f_T}
j=1
j=1
∑_{k=1}^{m_S} β_k
∑{i=1}^{n{T,U}}
(f_T(x_i^{T,U}) − f_k^S(x_i^{T,U}))^2 + λ_3 Ω(f_T)。
+λ_1
k=1
i=1
与 Fast-DAM 类似,同样可以采用 ε-不敏感损失函数 [114]。
5.2 参数控制策略 {#sec-5-2}
参数控制策略聚焦于模型的参数。例如,在目标分类任务中,可通过形状、颜色等物体属性 [121] 将已知源类别的知识迁移到目标类别中。属性先验(即与各属性对应的图像特征的概率分布参数)可从源域中学习得到,进而用于辅助目标分类器的学习。模型的参数实际上反映了模型所学到的知识,因此完全可以在参数层面进行知识迁移。
5.2.1 参数共享 {#sec-5-2-1}
一种直观的参数控制方式是将源学习器的参数直接共享给目标学习器。参数共享应用广泛,尤其在基于网络的方法中。例如,对于面向源任务的神经网络,可以冻结(即共享)其大部分层,仅对最后几层进行微调以生成目标网络。基于网络的方法将在第 5.4 节介绍。除了基于网络的参数共享外,基于矩阵分解的参数共享也是可行的。例如,Zhuang 等人针对文本分类提出了一种方法,称为基于矩阵三分解的分类框架(MTrick)[122]。作者观察到,在不同领域中,不同的词或短语有时表达相同或相似的含义。因此,相较于直接使用词语本身,使用词语背后的概念作为桥梁来迁移源域中的知识更为有效。与利用概念构建贝叶斯网络的基于 PLSA 的迁移学习方法不同,MTrick 试图寻找文档类别与词簇所传达概念之间的联系
15
通过矩阵三因子分解实现。这些关联被视为待迁移的稳定知识。其核心思想是将文档-词矩阵分解为三个矩阵,即文档-聚类矩阵、关联矩阵和聚类-词矩阵。具体而言,通过分别在源域和目标域的文档-词矩阵上执行矩阵三因子分解操作,构造如下联合优化问题:
min_{Q,R,W} ||X_S - Q_S R S_R W_S||^2 + λ_1 ||X_T - Q_T R W_T||^2
- λ_2 ||Q_S - ˘Q_S||^2
s.t. Normalization Constraints,
其中,X 表示文档-词矩阵,Q 表示文档-聚类矩阵,R 表示从文档聚类到词聚类的变换矩阵,W 表示聚类-词矩阵,n_d 表示文档数量,˘Q_S 表示标签矩阵。矩阵 ˘Q_S 基于源域文档的类别信息构建,若第 i 篇文档属于第 k 类,则 ˘Q_S[i,k] = 1。在上述目标函数中,矩阵 R 实际上是共享参数。第一项旨在对源域文档-词矩阵进行三因子分解,第二项对目标域文档-词矩阵进行分解,最后一项则融入源域标签信息。该优化问题基于交替迭代方法求解。一旦得到 Q_T 的解,目标域第 k 个实例的类别索引即为 Q_T 第 k 行中最大值所对应的类别。
此外,Zhuang 等人扩展了 MTrick,并提出了一种称为 Triplex Transfer Learning(TriTL)的方法 [123]。MTrick 假设各域共享其词聚类背后的相似概念。相比之下,TriTL 假设这些域的概念可进一步划分为三类,即域无关概念、可迁移的域特有概念和不可迁移的域特有概念,这与 HIDC 的思想类似。该思路源自 Dual Transfer Learning(DTL),后者假设概念由域无关概念和可迁移的域特有概念组成 [124]。TriTL 的目标函数定义如下:
min_{Q,R,W} ∑_{k=1}^{m_S+m_T} ||X^k - Q^k [R^{DI} R^{TD} R^{ND}]
⎡
⎣ W^{DI}
W^{TD}_k
W^{ND}_k
⎤ ⎦||^2
min Q,R,W
s.t. Normalization Constraints,
其中各符号的定义与 MTrick 类似,下标 k 表示域的索引,假设前 m_S 个域为源域,后 m_T 个域为目标域。作者提出了一种迭代算法来求解该优化问题。在初始化阶段,W^{DI} 和 W^{TD}_k 基于 PLSA 算法的聚类结果进行初始化,而 W^{UT}_k 则采用随机初始化;PLSA 算法在所有域实例的合并数据上执行。
还有一些基于矩阵分解发展而来的其他方法。Wang 等人提出了一种用于图像分类的迁移学习框架 [125]。Wang 等人
16
提出了一种软关联方法,将两种矩阵三因子分解集成到一个联合框架中 [126]。Do 等人利用矩阵三因子分解来发现跨域推荐中隐式和显式的相似性 [127]。
5.3 模型集成策略 {#sec-5-3}
在涉及产品评论的情感分析应用中,来自多个产品领域的数据或模型可作为源领域加以利用[131]。然而,由于这些领域的分布彼此不同,将数据或模型直接合并到单一领域并不一定能取得理想效果。模型集成是另一种常用的策略,其目标是将若干弱分类器组合起来以生成最终预测。前文提及的一些迁移学习方法已采用该策略,例如 TrAdaBoost 通过投票方式集成弱分类器,而 MsTrAdaBoost 则通过加权方式实现集成。本节将介绍几种典型的基于集成的迁移学习方法,以帮助读者更好地理解该策略的功能与应用场景。
如第 4.1 节所述,文献[33]提出了 TaskTrAdaBoost,作为 TrAdaBoost 在多源场景下的扩展。TaskTrAdaBoost 主要包含以下两个阶段。
-
候选分类器构建:在第一阶段,通过在每个源领域上执行 AdaBoost 来构建一组候选分类器。需要注意的是,对于每个源领域,AdaBoost 的每次迭代都会生成一个新的弱分类器。为避免过拟合问题,作者引入了一个阈值,以将合适的分类器挑选到候选组中。
-
分类器选择与集成:在第二阶段,对目标领域实例执行改进版的 AdaBoost,以构建最终分类器。在每次迭代中,挑选出对已标记目标领域实例分类误差最小的最优候选分类器,并根据该误差为其赋予权重;随后,根据所选分类器在目标领域上的表现更新每个目标领域实例的权重。迭代过程结束后,将所选分类器进行集成以生成最终预测。
原始 AdaBoost 与 TaskTrAdaBoost 第二阶段之间的差异在于:前者在每次迭代中对加权的目标领域实例构建一个新的候选分类器;而后者则在加权的目标领域实例上,从预先获得的候选分类器中挑选分类误差最小的那个。
Gao 等人的工作提出了另一种被称为局部加权集成 (LWE) 的基于集成的框架[132]。LWE 关注于多个学习器的集成过程,这些学习器既可在不同源领域上分别构建,也可在同一源领域上通过不同的学习算法训练得到。与 TaskTrAdaBoost 学习每个学习器全局权重的方式不同,LWE 的作者采用了局部权重策略,即根据目标领域测试集的局部流形结构为各学习器分配合适的权重。在 LWE 中,同一学习器在分类不同目标领域实例时通常会被赋予不同的权重。具体而言,作者采用基于图的方法来估计这些权重。加权步骤概述如下。
- 图构建:对于第 i 个源学习器,利用该学习器对目标领域测试集进行分类,以构建图 G^{T}_{S_i}
5.2.2 参数约束 {#sec-5-2-2}
另一类参数控制型策略是约束参数。与强制模型共享部分参数的参数共享策略不同,参数约束策略仅要求源模型与目标模型的参数彼此相似。
以类别学习方法为例。类别学习问题旨在仅利用有限的目标领域实例以及预先获得的 k 个二元决策函数,学习用于预测新类别(即第 (k+1) 类)的决策函数。这些预先获得的决策函数用于预测某个实例属于这 k 个类别中的哪一类。为解决该类别学习问题,Tommasi 等人提出了被称为单模型知识迁移 (SMKL) 的方法[128]。SMKL 基于最小二乘支持向量机 (LS-SVM)。LS-SVM 的优势在于其将不等式约束转化为等式约束,从而具备较高的计算效率;其优化过程等价于求解一个线性方程组问题,而非二次规划问题。SMKL 从预先获得的二元决策函数中选取一个,并迁移其参数所包含的知识。其目标函数如下所示
\theta -\beta\tilde{\theta}
\sum^{n_{T,L}}
\eta_j\left(f(x^{T,L}_j) - y^{T,L}_j\right)^2,
\min_f \frac{1}{2}
2
2
其中 f(x) = θ · Φ(x) + b,β 是控制迁移程度的加权参数,˜θ 是所选预训练模型的参数,ηj 是用于缓解标签不平衡问题的系数。核参数和权衡参数通过交叉验证选取。为寻找最优加权参数,作者参考了早期工作 [129]。在 [129] 中,Cawley 针对 LS-SVM 提出了一种基于留一交叉验证的模型选择机制。该方法的优势在于,无需真正执行交叉验证实验即可以闭式形式获得每个实例的留一误差。受 Cawley 工作的启发,泛化误差可在 SMKL 中被便捷地估计,从而指导参数设置。Tommasi 等人进一步利用所有预训练得到的决策函数对 SMKL 进行了扩展。在 [130] 中,他们提出了一种被称为多模型知识迁移(MMKL)的方法,其目标函数如下:
θ −
k
X
2
nT,L
j=1
ηj
f(xT,L
j
) −yT,L
j
min
f
1
2
- λ
i=1
5.4 深度学习技术 {#sec-5-4}
深度学习方法在机器学习领域尤为流行,许多研究者利用深度学习技术来构建迁移学习模型。例如,第 4.2.6 节中介绍的 SDA 和 mSLDA 方法就采用了深度学习技术。本小节将专门讨论与深度学习相关的迁移学习模型,并将所介绍的深度学习方法划分为两类:非对抗式(即传统式)方法和对抗式方法。
5.4.1 传统深度学习 {#sec-5-4-1}
如前所述,自编码器在深度学习领域中被广泛使用。除了 SDA 和 mSLDA 之外,还有一些基于重构的迁移学习方法。例如,Zhuang 等人的论文提出了一种称为基于深度自编码器的迁移学习(TLDA)的方法 [44]、[134]。TLDA 分别针对源域和目标域采用两个自编码器,这两个自编码器共享相同的参数,其编码器和解码器均包含带有激活函数的两层结构。两个自编码器的结构示意图如下:
XS (W1,b1) ──→ QS (W2,b2) ─────────→ Softmax Regression RS (Ŵ2,b̂2) ──→ Q̃S (Ŵ1,b̂1) ──→ X̃S,
⇑ KL 散度 ⇓
XT (W1,b1) ──→ QT (W2,b2) ─────────→ Softmax Regression RT (Ŵ2,b̂2) ──→ Q̃T (Ŵ1,b̂1) ──→ X̃T。
TLDA 包含若干优化目标,具体如下。1. 重构误差最小化:解码器的输出应当与编码器的输入尽可能接近。换言之,XS 与 X̃S 之间的距离以及 XT 与 X̃T 之间的距离都应当最小化。2. 分布适配:QS 与 QT 之间的分布差异应当最小化。3. 回归误差最小化:编码器在带标签源域实例上的输出,即 RS,应当与对应的标签信息 YS 保持一致。因此,TLDA 的目标函数为:
min Θ LREC(X, X̃) + λ1 KL(QS||QT) + λ2 Ω(W, b, Ŵ, b̂)
- λ3 LREG(RS, YS),
其中第一项表示重构误差,KL(·) 表示 KL 散度,第三项用于控制模型复杂度,最后一项表示回归误差。TLDA 通过梯度下降法进行训练。最终的预测可以通过两种不同的方式实现:第一种方式是直接利用编码器的输出进行预测;第二种方式是将自编码器视为特征提取器,然后利用编码器第一层输出的特征表示在带标签实例上训练目标分类器。
除了基于重构的领域适配之外,基于差异度量的领域适配也是一条重要的研究方向。在早期研究中,浅层神经网络曾被尝试用于学习与领域无关的特征表示 [135],但研究表明浅层结构往往难以使所得模型取得优异的性能。因此,许多研究转向利用深度神经网络。Tzeng 等人 [136] 在深度神经网络中增加了一个适配层和一项差异损失,从而提升了性能。在此基础上,Long 等人进一步实现了多层适配,并采用了多核技术,提出了一种称为深度适配网络(DAN)的架构 [137]。为了更好地理解,下面详细介绍 DAN。
full ──→ 第 6 层 RS_6, full ──→ 第 7 层 RS_7, full ──→ 第 8 层 RS_8, f(XS)
XS
conv ──→ ··· QS_5, QT_5 |
XT conv ──→ 第 1 层 QS_1, QT_1
ր
⇑ MK-MMD ⇓
⇑ MK-MMD ⇓
⇑ MK-MMD ⇓
ց
{z
}
五个卷积层 full ──→ 第 6 层 RT_6, full ──→ 第 7 层 RT_7, full ──→ 第 8 层 RT_8, f(XT)
{z
}
|
三个全连接层
DAN 包含以下优化目标。1. 分类误差最小化:应最小化带标签实例上的分类误差,采用交叉熵损失函数来度量带标签实例的预测误差。2. 分布适配:包括表示层和输出层在内的多个层可以以逐层的方式联合适配。作者不再使用单核 MMD 来度量分布差异,而是采用 MK-MMD,并使用 MK-MMD 的线性时间无偏估计来避免大量内积运算 [62]。3. 核参数优化:MK-MMD 中多个核的权重参数应当被优化以最大化检验功效 [62]。DAN 网络的目标函数如下:
nL
∑
8
∑
minΘ maxκ
其中 l 表示层的索引。上述优化实际上是一个极小极大优化问题。针对核函数 κ 最大化目标函数的目的是提高检验功效。经过这一步,源域和目标域之间细微的分布差异被放大。这一思路类似于生成对抗网络(GAN)[139]。在训练过程中,DAN 网络由预训练的 AlexNet [138] 进行初始化。需要学习两类参数,即网络参数
18
以及多核的加权参数。鉴于前三个卷积层输出的是通用特征且具有可迁移性,作者将它们冻结,并对最后两个卷积层以及两个全连接层进行微调 [140]。最后一个全连接层(即分类器层)则从零开始训练。Long 等人进一步扩展了上述 DAN 方法,并提出了 JAN 框架 [141]。其新特点总结如下。
- 正则项的引入:该框架额外引入一个正则项,以最小化无标签目标域样本预测标签的不确定性,其动机来源于熵最小化准则 [142]。2. 架构的泛化:JAN 框架可应用于许多其他架构,例如 GoogLeNet [143] 和 ResNet [144]。3. 度量的泛化:分布差异也可以由其他度量来估计。例如,除了 MK-MMD 之外,作者还提出了用于分布适应的均值嵌入检验 [145]。
JAN 框架的目标函数如下:
nL
∑
lend
∑
minΘ maxκ
nT,U
∑
∑
- λ2
i=1
其中 lstrt 和 lend 表示用于分布适应的全连接层的边界索引。还有一些其他值得关注的工作。例如,Long 等人受深度残差学习 [146] 的启发,构建了用于领域适应的残差迁移网络。此外,Long 等人的另一项工作提出了联合适应网络(Joint Adaptation Network,JAN)[147],该网络对多层的联合分布差异进行自适应。Sun 和 Saenko 将 CORAL 扩展到深度领域适应中,并提出了称为 Deep CORAL(DCORAL)的方法,其中通过添加 CORAL 损失来最小化特征协方差 [148]。Chen 等人认识到具有相同标签的样本在特征空间中应当彼此接近,因此他们不仅加入了 CORAL 损失,还加入了一种基于实例的类间差异损失 [149]。Pan 等人构建了三个原型网络(分别对应 DS、DT 以及 DS∪DT),并融入了多模型共识的思想。他们还采用伪标签策略,同时自适应实例级和类级的差异 [150]。Kang 等人提出了基于称为对比领域差异的度量指标的对比适应网络(Contrastive Adaptation Network,CAN)[151]。Zhu 等人旨在对所提取的多种特征表示进行自适应,提出了多表示适应网络(Multi-Representation Adaptation Network,MRAN)[152]。深度学习技术也可用于多源迁移学习。例如,Zhu 等人的工作提出了称为多特征空间适应网络(Multiple Feature Spaces Adaptation Network,MFSAN)的框架 [153]。MFSAN 的架构由一个公共特征提取器、mS 个
领域专属特征提取器以及 mS 个领域专属
分类器组成。相应的示意图如下所示。
XS1 ··· XSk ··· XS mS XT 公共−−−−−→ 提取器 QS1 ··· QSk ··· QS mS QT
领域专属−−−−−−−−−→ 提取器
Ŷ S1 ··· Ŷ Sk ··· Ŷ SmS Ŷ T1 ··· Ŷ Tk ··· Ŷ TmS
RS1 ··· RSk ··· RSmS RT1 ··· RTk ··· RTmS
领域专属−−−−−−−−−→ 分类器
在每次迭代中,MFSAN 包含以下步骤。1. 共同特征提取:对于每个源域(记为 DSk,其中 k = 1, · · · , mS),将源域实例(记为 XSk)分别输入共同特征提取器,以生成位于共同隐空间中的实例(记为 QSk)。对目标域实例(记为 XT)也执行类似操作,得到 QT。2. 特定特征提取:对于每个源域,将提取得到的共同特征 QSk 送入第 k 个领域特定特征提取器。同时,将 QT 送入所有领域特定特征提取器,得到 RTk,其中 k = 1, · · · , mS。3. 数据分类:将第 k 个领域特定特征提取器的输出输入第 k 个分类器。由此以概率形式预测得到 mS 对分类结果。4. 参数更新:更新网络参数以优化目标函数。MFSAN 包含三个目标,即分类误差最小化、分布适配和共识正则化。目标函数如下:
mS
X
i=1
i=1
min
mS
YˆiT − YˆjT
- λ2
i̸=j
其中,第一项表示有标签源域实例的分类误差,第二项度量分布差异,第三项度量对目标域实例预测结果之间的不一致性。
5.4.2 对抗深度学习 {#sec-5-4-2}
对抗学习的思想可以被集成到基于深度学习的迁移学习方法中。如前所述,在 DAN 框架中,网络 Θ 和核 κ 进行极小极大博弈,这体现了对抗学习的思想。然而,DAN 框架在对抗匹配方面与传统基于 GAN 的方法略有不同。在 DAN 框架中,极大化博弈中需要优化的参数很少,这使得优化过程更容易达到均衡。在介绍对抗式迁移学习方法之前,我们先简要回顾原始 GAN 框架及相关工作。受双人博弈启发的原始 GAN [139] 由两个模型组成:生成器 G 和判别器 D。生成器生成真实数据的伪造样本,目的是迷惑判别器并使其产生错误的判断。
19
判别器接收真实数据与伪造样本的混合输入,其目标是判断样本是真实的还是伪造的。这两个模型实际上进行的是双人极小极大博弈,其目标函数如下:
minG maxD Ex∼Ptrue[log D(x)] + E˜z∼P˜z [log(1 − D(G(˜z)))]
其中,˜z 表示从某一噪声分布中采样得到的噪声实例,用作生成器的输入以生成伪造样本。整个 GAN 可以使用反向传播算法进行训练。当双人博弈达到均衡时,生成器能够产生几乎以假乱真的样本。受 GAN 启发,许多迁移学习方法基于以下假设构建:良好的特征表示几乎不包含关于实例原始领域的可判别信息。例如,Ganin 等人的工作提出了一种用于领域适应的深度架构,称为领域对抗神经网络(DANN)[154], [155]。DANN 假设不存在可用的有标签目标域实例。其架构由特征提取器、标签预测器和领域判别器组成。相应的示意图如下。
YˆS,L YˆT,U
↑ 标签预测器
↑
QS,L 领域判别器
Ŝ Tˆ (领域标签)
XS,L
XT,U 特征提取器
QT,U
特征提取器的作用类似于生成器,其目标是产生与领域无关的特征表示,以迷惑领域判别器。领域判别器则承担类似判别器的角色,试图判断所提取的特征来自源领域还是目标领域。此外,标签预测器根据已标记源领域实例(即QS,L)所提取的特征产生实例的标签预测结果。DANN可通过插入一个特殊的梯度反转层(GRL)进行训练。在整个系统训练完成后,特征提取器即可学习到实例的深层特征,输出 ˆY T,U 即为未标记目标领域实例的预测标签。 还有一些其他相关的重要工作。Tzeng等人提出了一个统一的对抗领域自适应框架 [156]。Shen等人采用Wasserstein距离进行领域自适应 [59]。Hoffman等人引入循环一致性损失以保证结构与语义的一致性 [157]。Long等人提出了条件领域对抗网络(CDAN),利用条件领域判别器辅助对抗自适应 [158]。Zhang等人采用源分类器和目标分类器的对称设计 [159]。Zhao等人利用领域对抗网络解决多源迁移学习问题 [160]。Yu等人提出了动态对抗自适应网络 [161]。 部分方法针对特定场景设计。以部分迁移学习为例,部分迁移学习方法适用于目标领域类别少于源领域类别(即 YS ⊆ YT)的场景。此时,不同标签的源领域实例对领域自适应的重要性可能不同。
具体而言,源领域与目标领域中具有相同标签的实例更可能潜在关联。然而,由于目标领域实例未标记,如何识别并部分迁移已标记源领域实例中的重要信息成为一个关键问题。 Zhang等人针对部分领域自适应提出了一种方法,称为基于重要性加权对抗网络的领域自适应(IWANDA)[162]。IWANDA的架构与DANN不同。DANN采用一个公共特征提取器,其前提是存在一个公共特征空间,使QS,L与QT,U具有相似的分布。然而,IWANDA分别为源领域和目标领域使用了两个领域专属的特征提取器。具体来说,IWANDA由两个特征提取器、两个领域判别器以及一个标签预测器组成。IWANDA的结构图如下所示。
ˆY S,L ˆY T,U
标签 预测器
↑ QS,L
XS,L 源特征 提取器
+βS → + ˆY T,U
ˆS2 ˆT2
第2领域 判别器
XT,U 目标特征 提取器 QT,U
↓
ˆS1 ˆT1
权重 函数 βS
第1领域 判别器
训练之前,源特征提取器与标签预测器需在已标记源领域实例上进行预训练。这两个组件在训练过程中保持冻结,即仅优化目标特征提取器与领域判别器。在每次迭代中,上述网络按以下步骤进行优化。 1. 实例加权:为解决部分迁移问题,源领域实例根据第一个领域判别器的输出被赋予权重。第一个领域判别器以QS,L和QT,U作为输入,并输出它们所属领域的概率预测。若一个源领域实例被高概率预测属于目标领域,则该实例很可能与目标领域相关。因此,该实例被赋予较大的权重,反之亦然。 2. 预测生成:标签预测器输出实例的标签预测结果。第二个判别器预测实例所属的领域。 3. 参数更新:第一个判别器被优化以最小化领域分类误差。第二个判别器与目标特征提取器进行极小极大博弈。该判别器旨在检测一个实例是来自目标领域,还是来自加权后的源领域,并降低标签预测 ˆY T,U 的不确定性。目标特征提取器则试图迷惑第二个判别器。这些组件可以采用与GAN类似的方式或通过插入GRL进行优化。 除IWANDA外,Cao等人构建了用于部分迁移学习的选择性对抗网络 [163]。还有一些其他相关研究
20
迁移学习的相关工作。例如,Wang 等人提出了一种基于极小极大的方法来挑选高质量的源域数据 [164]。Chen 等人研究了对抗域适应中的可迁移性与判别性,并提出了一种谱正则化方法以增强现有的对抗迁移学习方法 [165]。
6 应用 {#sec-6}
在前述各节中,我们介绍了多种具有代表性的迁移学习方法,这些方法在其原始论文中已被应用于解决各类与文本或图像相关的实际问题。例如,MTrick [122] 和 TriTL [123] 利用矩阵分解技术解决跨域文本分类问题;DAN [137]、DCORAL [148] 以及 DANN [154]、[155] 等基于深度学习的方法则被应用于图像分类任务。本节不再笼统地讨论文本或图像类应用,而是聚焦于迁移学习在医学、生物信息学、交通以及推荐系统等具体领域的应用。
6.1 医学应用 {#sec-6-1}
医学影像在医疗领域扮演着重要角色,是辅助诊断的有力工具。随着机器学习等计算机技术的发展,计算机辅助诊断已成为一个备受关注且前景广阔的研究方向。需要注意的是,医学图像由专用医疗设备生成,其标注往往依赖于经验丰富的医生,因此在很多情况下,收集足够数量的训练数据既昂贵又困难。迁移学习技术可以应用于医学影像分析。一种常用的做法是:先在源域(例如包含超过一千四百万张标注图像、涵盖两万余个类别的图像数据库 ImageNet [166])上预训练神经网络,再利用目标域样本对其进行微调。 例如,Maqsood 等人对 AlexNet [138] 进行了微调,用于阿尔茨海默病的检测 [167]。其方法包含以下四个步骤:首先,对目标域中的 MRI 图像进行预处理,执行对比度拉伸操作;其次,在 ImageNet [166](即源域)上对 AlexNet [138] 进行预训练,以此作为学习新任务的起点;再次,固定 AlexNet 的卷积层,并将其最后三个全连接层替换为新的结构,包括一个 softmax 层、一个全连接层和一个输出层;最后,在阿尔茨海默病数据集 [168](即目标域)上对修改后的 AlexNet 进行微调。实验结果表明,该方法在多类分类任务(即阿尔茨海默病分期检测)中取得了最高的准确率。 类似地,Shin 等人通过微调预训练深度神经网络来解决计算机辅助检测问题 [169]。Byra 等人利用迁移学习技术辅助评估膝关节骨关节炎 [170]。除影像分析外,迁移学习在医学领域还有其他应用。例如,Tang 等人
结合主动学习与域适应技术,对多种医学数据进行分类 [171]。Zeng 等人利用迁移学习自动编码用于描述患者诊断信息的 ICD-9 编码 [172]。
6.2 生物信息学应用 {#sec-6-2}
生物序列分析是生物信息学领域的一项重要任务。由于对某些生物体的认识可以迁移到其他生物体,因此可以借助迁移学习来促进生物序列分析。该应用中存在显著的分布差异问题。例如,某些生物物质的功能可能保持不变,但其组成在两个生物体之间发生了变化,这可能导致边缘分布差异。此外,若两个生物体具有共同祖先但进化距离较远,则条件分布差异会非常显著。Schweikert 等人以 mRNA 剪接位点预测问题为例,分析了迁移学习方法的有效性[173]。在其实验中,源域包含来自被深入研究的模式生物秀丽隐杆线虫(C. elegans)的序列实例,目标生物体则包括另外两种线虫(即 C. remanei 和 P. pacificus)、黑腹果蝇(D. melanogaster)以及植物拟南芥(A. thaliana)。多种迁移学习方法(例如 FAM[64] 和 KMM[5] 的变体)被相互比较。实验结果表明,迁移学习有助于提升分类性能。 生物信息学领域中另一类常见的任务是基因表达分析,例如预测基因与表型之间的关联。在该应用中,主要挑战之一是数据稀疏问题,因为已知关联的数据通常非常少。迁移学习可以通过提供额外的信息和知识来缓解这一问题。例如,Petegrosso 等人[174]提出了一种基于标签传播算法(Label Propagation Algorithm, LPA)[175]的迁移学习方法,用于分析和预测基因–表型关联。LPA 利用蛋白质–蛋白质相互作用(Protein-Protein Interaction, PPI)网络和初始标记,基于“PPI 网络中相连的基因应具有相似标签”的假设来预测目标关联。作者将多任务和迁移学习技术融入 LPA,对其进行了扩展。首先,利用提供了人类疾病表型特征标准化词汇的人类表型本体(Human Phenotype Ontology, HPO)来构建辅助任务。如此一来,便可同时利用表型路径以及 HPO 与 PPI 网络中的链接知识进行关联预测:PPI 中发生相互作用的基因更可能关联同一表型,HPO 中相连的表型也更可能关联同一基因。其次,将包含基因功能与基因关联信息的基因本体(Gene Ontology, GO)作为源域,并设计了额外的正则化项,以 PPI 网络和共有基因作为知识迁移的桥梁。针对 PPI 网络中的全部基因,同时构建基因–GO 条目关联和基因–HPO 表型关联。通过迁移额外的知识,所预测的基因–表型关联能够更加可靠。
21
通过迁移额外的知识,所预测的基因–表型关联能够更加可靠。 迁移学习也可应用于蛋白质–蛋白质相互作用(PPI)预测问题。Xu 等人[176]提出了一种方法,将链接知识从源 PPI 网络迁移到目标 PPI 网络。该方法基于协同矩阵分解技术[177],通过在多个领域间共享一个因子矩阵来实现知识迁移。
6.3 交通领域的应用 {#sec-6-3}
迁移学习在交通领域的一个应用是理解交通场景图像。在该应用中,一个具有挑战性的问题是,从特定地点采集的图像往往因天气和光照条件的变化而产生差异。为了解决该问题,Di 等人提出了一种方法,旨在迁移同一地点在不同条件下拍摄的图像中的信息[178]。在第一步中,对预训练网络进行微调以提取图像的特征表示。在第二步中,采用特征变换策略来构建新的特征表示。具体而言,对所提取的特征执行降维算法(即偏最小二乘回归[179])以生成低维特征。随后,学习一个变换矩阵,以最小化降维数据的领域差异。接下来,采用子空间对齐操作以进一步缩小领域差异。需要注意的是,虽然不同条件下的图像通常具有不同的外观,但它们往往具有相似的布局结构。因此,在最后一步中,首先在测试图像与检索到的最佳匹配图像之间建立跨域稠密对应关系,然后通过马尔可夫随机场模型[180]、[181]将最佳匹配图像的标注迁移至测试图像。 迁移学习同样可应用于驾驶员行为建模任务。在该任务中,每个驾驶员的个性化数据通常难以获得。在此情形下,将历史数据中所蕴含的知识迁移到新加入的驾驶员身上是一种颇具前景的替代方案。例如,Lu 等人针对变道场景提出了驾驶员模型自适应方法[182]。其中,源域拥有描述源驾驶员行为的充足数据,而目标域仅包含少量关于目标驾驶员的数据。在第一步中,对来自两个域的数据执行 PCA 预处理以生成低维特征。作者假设源数据和目标数据分别来自两个流形。因此,在第二步中,采用流形对齐方法进行领域自适应。具体而言,使用动态时间规整算法[183]衡量相似性,并为每个目标域数据点寻找对应的源域数据点。然后,基于所获得的数据点对应关系,采用局部普鲁克分析[184]对齐两个流形。如此,便可将源域数据迁移至目标域。最后一步中,使用随机建模方法(例如高斯混合回归[185])对目标驾驶员的行为进行建模。
实验结果表明,即便仅有少量目标域数据可用,所提迁移学习方法亦能对目标驾驶员起到帮助作用。此外,结果还显示,当目标样本数量极少或极多时,该方法的优势并不明显。这可能是因为在仅有少量目标域实例时难以准确发现跨域关系,而在目标域实例充足的情况下迁移学习的必要性也随之降低。 此外,迁移学习在交通领域还有一些其他应用。例如,Liu 等人将迁移学习应用于驾驶员姿态识别[186];Wang 等人在车辆类型识别中采用迁移学习的正则化技术[187]。迁移学习还可用于异常行为检测[188]、[189]以及交通标志识别[190]等任务。
6.4 推荐系统应用 {#sec-6-4}
随着信息量的迅速增长,如何为不同用户有效推荐个性化内容成为一个重要课题。在推荐系统领域,一些传统推荐方法(例如基于因子分解的协同过滤)通常依赖于对用户–物品交互矩阵进行分解以获得预测函数。这类方法往往需要大量训练数据才能给出准确的推荐结果。然而,所需的训练数据(例如历史交互数据)在真实场景中通常是稀疏的。此外,对于新注册的用户或新加入的物品,传统方法往往难以给出有效推荐,这也被称为冷启动问题。 针对上述推荐系统中存在的问题,已有多种迁移学习方法被提出,例如基于实例的方法和基于特征的方法。这些方法尝试利用其他推荐系统(即源领域)的数据,辅助目标领域中推荐系统的构建。基于实例的方法主要关注将不同类型的实例(例如评分、反馈和点击)从源领域迁移到目标领域。Pan 等人[191]的工作利用了源领域中以评分分布形式表示的不确定评分进行知识迁移。具体而言,源领域的不确定评分被用作约束条件,以辅助完成目标领域上的评分矩阵分解任务。Hu 等人[192]提出了一种称为 transfer meeting hybrid 的方法,该方法通过注意力记忆网络从非结构化文本中提取知识,并有选择地迁移有用信息。 基于特征的方法则通常在一个潜在特征空间中利用并迁移信息。例如,Pan 等人提出了一种称为坐标系迁移(Coordinate System Transfer,CST)[193]的方法,以同时利用用户侧和物品侧的潜在特征。源领域实例来自另一个推荐系统,且与目标领域共享部分用户和物品。CST 的基本假设是:反映用户偏好或物品因素的主成分坐标刻画了与领域无关的结构,因而可以在不同领域之间迁移。
22
CST 首先通过对源领域数据施加稀疏矩阵三因子分解,构建出两个主成分坐标系(即用户和物品的潜在特征),随后将其作为约束迁移到目标领域。实验结果表明,在各种数据稀疏程度下,CST 均显著优于非迁移基线方法(即均值填充模型和潜在因子模型)[193]。 还有一些关于跨领域推荐的其他研究[194]、[195]、[196]、[197]。例如,He 等人提出了一种基于贝叶斯神经网络的迁移学习框架[198]。Zhu 等人[199]提出了一种深度框架,该框架首先基于矩阵分解技术生成用户和物品的特征表示,然后利用深度神经网络学习跨领域的特征映射。Yuan 等人[200]提出了一种基于自编码器和改进版 DANN[154]、[155] 的深度领域自适应方法,用于从评分矩阵中提取并迁移实例。
6.5 其他应用 {#sec-6-5}
通信应用:除WiFi定位任务[2]、[36]外,迁移学习也已应用于无线网络相关场景。例如,Bastug等人提出了一种缓存机制[201],将蕴含于设备交互中的上下文信息所包含的知识迁移至目标域。此外,部分研究关注节能问题。Li等人针对蜂窝无线接入网络提出了一种节能方案[202],利用了迁移学习的思想。Zhao和Grace则将迁移学习应用于拓扑管理以降低能耗[203]。
城市计算应用:随着城市相关数据的不断增长,城市计算在交通监测、医疗健康、社会治安等方向上已成为颇具前景的研究领域。迁移学习已被用于缓解众多城市计算应用中的数据稀缺问题。例如,Guo等人[204]针对连锁门店选址推荐提出了一种方法,将语义相关域(如拥有相同门店的其他城市以及目标城市的其他连锁门店)中的知识迁移到目标城市。Wei等人[205]提出了一种灵活的多模态迁移学习方法,将数据与标签都较为充足的城市中的知识迁移到目标城市,以缓解数据稀疏问题。
迁移学习还被应用于一些识别任务,例如手势识别[206]、人脸识别[207]、行为识别[208]以及语音情感识别[209]。此外,迁移学习思想也被融入到一些其他领域,例如情感分析[28]、[96]、[210]、欺诈检测[211]、社交网络[212]以及高光谱图像分析[54]、[213]。
7 实验 {#sec-7}
迁移学习技术已成功应用于众多实际场景。本节将在两个主流研究方向(即物体识别和文本分类)上,对若干代表性迁移学习模型进行实验以评估其性能。首先介绍所使用的数据集,随后给出实验结果与进一步的分析。
实验对若干代表性迁移学习模型进行了性能评估。具体而言,针对物体识别任务,在Office-31数据集上比较了若干算法;针对文本分类任务,在Reuters-21578数据集上比较了十四种算法;针对情感分类任务,在Amazon Reviews数据集上比较了十一种算法。首先介绍数据集。
7.1 数据集与预处理 {#sec-7-1}
实验中使用了三个数据集:Office-31、Reuters-21578和Amazon Reviews。为简便起见,本文主要关注分类任务。预处理后各数据集的统计信息如表3所示。
• Amazon Reviews2[107]是一个多领域情感数据集,包含了来自Amazon.com四个领域(Books、Kitchen、Electronics和DVDs)的产品评论。每个领域中每条评论都包含文本以及0到5之间的评分。在实验中,将评分小于3的评论定义为负面评论,其余定义为正面评论。统计所有评论中每个词的出现频次,并选取频次最高的5000个词作为每条评论的属性。如此,每个领域最终包含1000个正例、1000个负例以及约5000个无标记实例。实验中,从四个领域中两两组合,共生成十二个迁移任务。
7.2 实验设置 {#sec-7-2}
实验对若干代表性迁移学习模型进行了比较。具体而言,针对物体识别问题,在Office-31数据集上比较了八种算法;针对文本分类问题,在Reuters-21578数据集上对十四种算法进行了实验和评估;针对情感分类问题,在Amazon Reviews上比较了十一种算法。分类结果以准确率作为评价指标,其定义如下:
• Reuters-215783是一个具有层次结构的文本分类数据集,包含5个大类(Exchanges、Orgs、People、Places、Topics)。本实验选用其中最大的三个大类Orgs、People和Places,生成三个分类任务(Orgs vs People、Orgs vs Places、People vs Places)。在每个任务中,将对应两个大类下的子类分别划分为两部分,由此得到四部分,用以构成两个域。每个域包含约1000个实例,每个实例约有4500维特征。具体而言,以Orgs vs People任务为例,从Orgs中取一部分、从People中取一部分组合构成源域;类似地,其余两部分组合构成目标域。需要说明的是,这三个大类中的实例均带有标记。为了生成无标记实例,从数据集中选取这些带标记实例,并忽略其标签信息。
accuracy = |{x | xi ∈ Dtest ∧ f(xi) = yi}|
|Dtest|
其中 Dtest 表示测试数据,y 表示真实分类标签,f(x) 表示预测分类结果。需要注意的是,部分算法需要基分类器,在这些情况下,实验中使用线性核 SVM 作为基分类器。此外,源域实例均带有标签。而对于所执行的算法(TrAdaBoost 除外),目标域实例均无标签。每个算法运行三次,并以平均值作为实验结果。评估的迁移学习模型包括:HIDC [93]、TriTL [123]、CD-PLSA [91], [92]、MTrick [122]、SFA [106]、mSLDA [98], [99]、SDA [96]、GFK [102]、SCL [94]、TCA [36], [78]、CoCC [41]、JDA [38]、TrAdaBoost [31]、DAN [137]、DCORAL [148]、MRAN [152]、CDAN [158]、DANN [154], [155]、JAN [147] 和 CAN [151]。
• Office-31 [215] 是一个目标识别数据集,包含 31 个类别和 3 个领域,即 Amazon、Webcam 和 DSLR。这三个领域分别包含 2817、498 和 795 个实例。Amazon 中的图像是从 Amazon.com 采集的在线电商图片;Webcam 中的图像是由网络摄像头拍摄的低分辨率图片;DSLR 中的图像是由 DSLR 相机拍摄的高分辨率图片。实验中,从这三个领域中按顺序选取任意两个分别作为源域和目标域,共构成 6 个任务。
7.3 实验结果 {#sec-7-3}
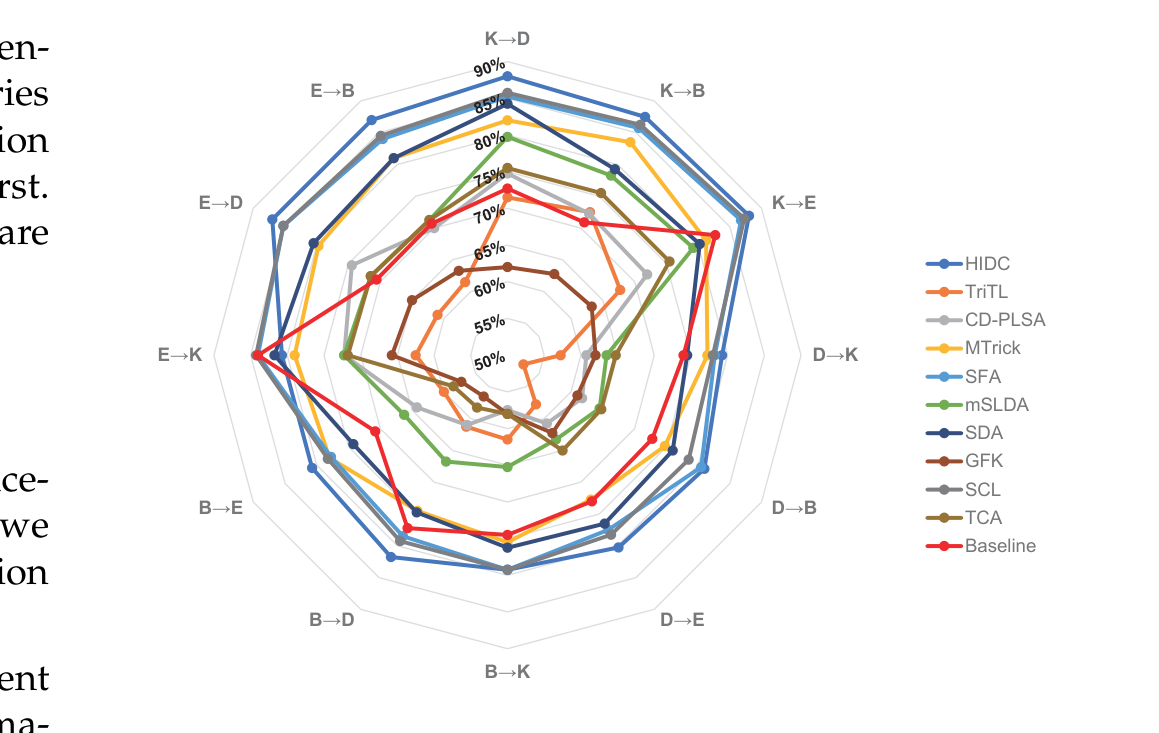
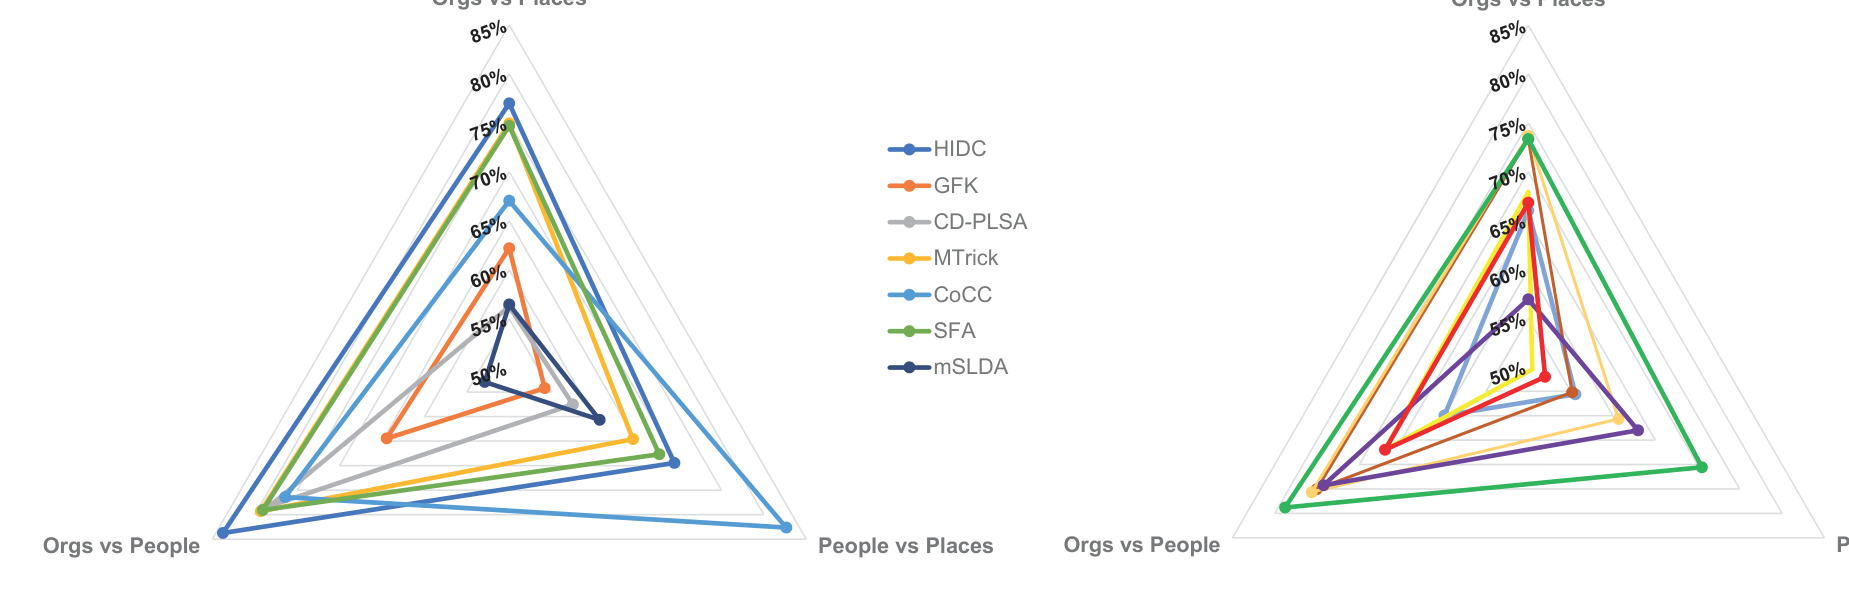
本节在三个数据集上对二十余种算法进行了比较。所有算法的参数均设置为原文给出的默认值或推荐值。实验结果分别列于表 4、表 5 和表 6,对应 Amazon Reviews、Reuters-21578 和 Office-31。为了让读者更直观地理解实验结果,文中给出了三幅雷达图,即图 5、图 6 和图 7,用于可视化实验结果。在雷达图中,每个方向代表一个任务,算法的整体性能通过由各顶点所构成的多边形来展示,各顶点表示该算法在对应任务上的准确率。
- https://github.com/FuzhenZhuang/Transfer-Learning-Toolkit
- http://www.cs.jhu.edu/~mdredze/datasets/sentiment/
- https://archive.ics.uci.edu/ml/datasets/Reuters-21578+Text+Categorization+Collection
24
表 3 预处理后数据集的统计信息。
领域 数据集 类别 属性 总实例数 任务数
情感分类 Amazon Reviews 4 5000 27677 12
文本分类 Reuters-21578 3 4772 6570 3
目标识别 Office-31 3 800 4110 6
SDA
TriTL
SCL
TCA
JDA
TrAdaBoost
Baseline
表 4 四个领域 Amazon Reviews 上的准确率性能:Kitchen (K)、Electronics (E)、DVDs (D) 和 Books (B)。
模型 K→D K→B K→E D→K D→B D→E B→K B→D B→E E→K E→D E→B 平均值
HIDC 0.8800 0.8750 0.8800 0.7925 0.8100 0.8025 0.7925 0.8175 0.8075 0.8075 0.8700 0.8700 0.8338
TriTL 0.7150 0.7250 0.6775 0.5725 0.5250 0.5775 0.6150 0.6125 0.6000 0.6250 0.6100 0.6150 0.6225
CD-PLSA 0.7475 0.7225 0.7200 0.6075 0.6175 0.6075 0.5750 0.6100 0.6425 0.7225 0.7450 0.7000 0.6681
MTrick 0.8200 0.8350 0.8125 0.7725 0.7475 0.7275 0.7550 0.7450 0.7800 0.7900 0.7975 0.8100 0.7827
SFA 0.8525 0.8575 0.8675 0.7825 0.8050 0.7750 0.7925 0.7850 0.7775 0.8400 0.8525 0.8400 0.8190
mSLDA 0.7975 0.7825 0.7925 0.6350 0.6450 0.6325 0.6525 0.6675 0.6625 0.7225 0.7150 0.7125 0.7015
SDA 0.8425 0.7925 0.8025 0.7450 0.7600 0.7650 0.7625 0.7475 0.7425 0.8175 0.8050 0.8100 0.7827
GFK 0.6200 0.6275 0.6325 0.6200 0.6100 0.6225 0.5800 0.5650 0.5725 0.6575 0.6500 0.6325 0.6158
SCL 0.8575 0.8625 0.8725 0.7800 0.7850 0.7825 0.7925 0.7925 0.7825 0.8425 0.8525 0.8450 0.8206
TCA 0.7550 0.7550 0.7550 0.6475 0.6475 0.6500 0.5800 0.5825 0.5850 0.7175 0.7150 0.7125 0.6752
Baseline 0.7270 0.7090 0.8270 0.7400 0.7280 0.7300 0.7450 0.7720 0.7080 0.8400 0.7060 0.7070 0.7449
表 4 给出了在 Amazon Reviews 上的实验结果。其中 Baseline 是仅在源域上训练的线性分类器(此处直接采用文献 [107] 中的结果)。图 5 对这些结果进行了可视化。从图 5 中可以看出,当源域为 electronics 或 kitchen 时,大多数算法的表现相对较好,这表明这两个领域相比其他两个领域可能包含更多的可迁移信息。此外,可以观察到 HIDC、SCL、SFA、MTrick 和 SDA 在全部 12 个任务上都表现良好且相对稳定。同时,其他算法(尤其是 mSLDA、CD-PLSA 和 TriTL)的表现则相对不稳定,其性能波动范围约为 20%。TriTL 在源域为 kitchen 的任务上准确率较高,但在其他任务上准确率较低。
TCA、mSLDA 和 CD-PLSA 在所有任务上具有相近的性能,平均准确率约为 70%。在表现较好的算法中,HIDC 和 MTrick 基于特征约简(特征聚类),而其他算法则分别基于特征编码(SDA)、特征对齐(SFA)和特征选择(SCL)。这些策略是当前基于特征的迁移学习的主流方法。表 5 给出了在 Reuter-21578 上的对比结果(此处直接采用了文献 [78] 和 [41] 中基线与 CoCC 的结果)。基线是仅使用目标域有标记样本训练得到的正则化最小二乘回归模型 [78]。图 6 与图 5 结构相同,可视化展示了各方法的性能。为清晰起见,十三种算法被分为两部分,分别对应图 6 中的两幅子图。可以观察到,对于 Orgs vs Places,大多数算法都表现相对较好,
25
这一现象表明 People 与 Places 之间的差异可能相对较大。TrAdaBoost 在该实验中表现较好,因为它利用目标域样本的标签来减小分布差异的影响。此外,HIDC、SFA 和 MTrick 在三项任务中性能较为稳定,这些算法在前面 Amazon Reviews 实验中同样表现良好。另外,在 People vs Places 任务上表现最好的两种算法是 CoCC 和 TrAdaBoost。在第三个实验中,七种基于深度学习的迁移学习模型(即 DAN、DCORAL、MRAN、CDAN、DANN、JAN 和 CAN)以及基线(即在 ImageNet [166] 上预训练后直接在目标域上训练的 AlexNet [138], [140])在 Office-31 数据集上进行了实验(此处直接采用原始论文 [137]、[147]、[151]、[158] 中 CDAN、JAN、CAN 和基线的结果)。所有这三种模型均使用 ResNet-50 [144] 作为骨干网络。实验结果如表 6 所示,平均性能如图 7 所示。由图 7 可见,这七种算法均具有优异的性能,特别是在 D→W 和 W→D 任务上,准确率非常接近 100%。这一现象反映了基于深度学习方法的优势,并与 Webcam 与 DSLR 之间差异小于 Webcam/DSLR 与 Amazon 之间差异这一事实相符。显然,CAN 的性能优于其余六种算法。在所有六个任务中,DANN 的性能与 DAN 相似,并优于 DCORAL,这表明引入对抗学习是有效且实用的。值得一提的是,在上述实验中,部分算法的性能并不理想。原因之一是我们采用了算法原始论文中的默认参数设置,而这些设置可能并不适用于我们所选的数据集。例如,GFK 最初是为物体识别设计的,在第一个实验中我们直接将其用于文本分类,结果并不理想(平均准确率约为 62%)。上述实验结果仅供参考。这些结果表明,某些算法可能不适合特定领域的数据集。因此,在研究过程中选择合适的算法作为基线十分重要。此外,在实际应用中同样需要找到合适的算法。
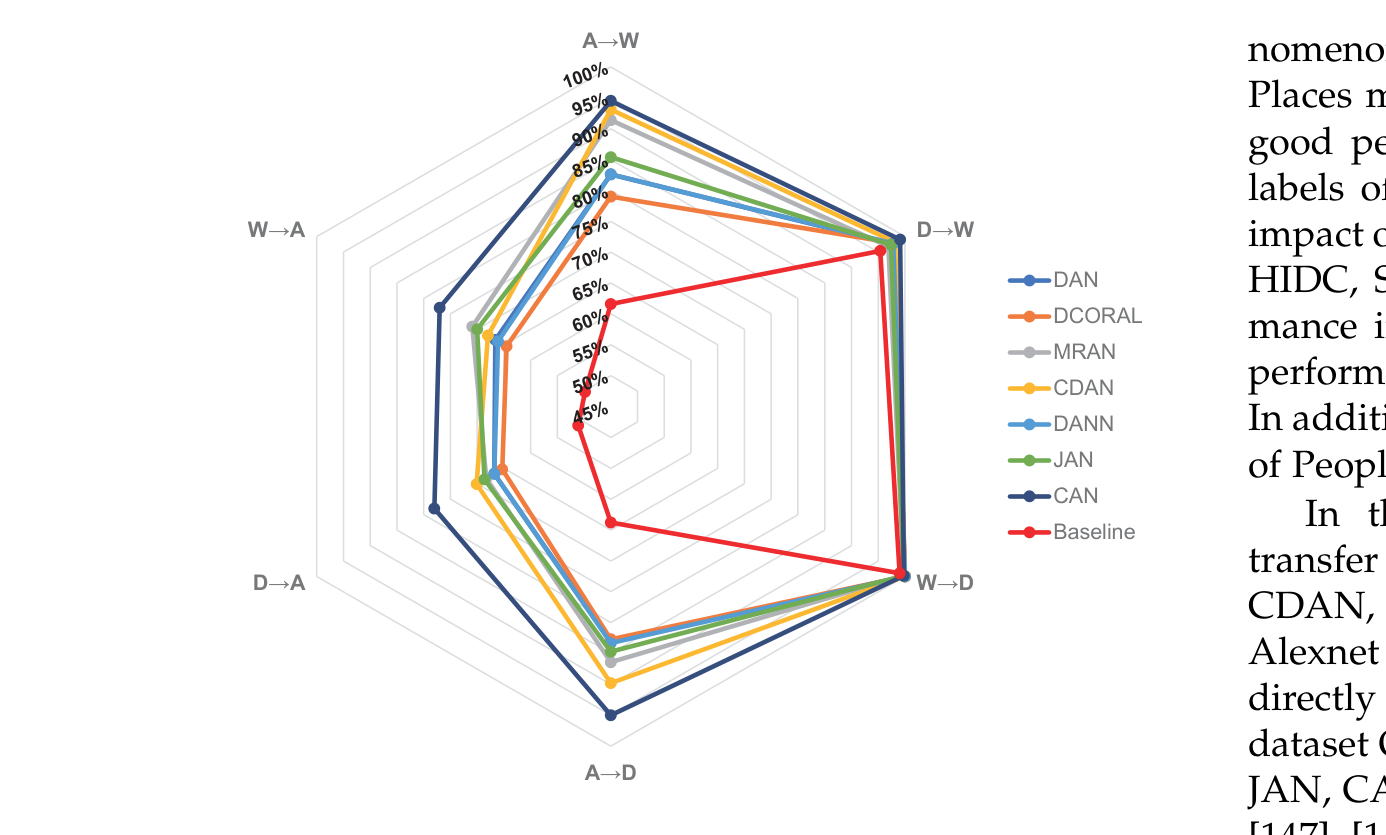
表 5 三个领域 Orgs、People 和 Places 在 Reuters-21578 上的准确率性能。
Model Orgs vs Places People vs Places Orgs vs People Average
HIDC 0.7698 0.6945 0.8375 0.7673
TriTL 0.7338 0.5517 0.7505 0.6787
CD-PLSA 0.5624 0.5749 0.7826 0.6400
MTrick 0.7494 0.6457 0.7930 0.7294
CoCC 0.6704 0.8264 0.7644 0.7537
SFA 0.7468 0.6768 0.7906 0.7381
mSLDA 0.5645 0.6064 0.5289 0.5666
SDA 0.6603 0.5556 0.5992 0.6050
GFK 0.6220 0.5417 0.6446 0.6028
SCL 0.6794 0.5046 0.6694 0.6178
TCA 0.7368 0.6065 0.7562 0.6998
JDA 0.5694 0.6296 0.7424 0.6471
TrAdaBoost 0.7336 0.7052 0.7879 0.7422
Baseline 0.6683 0.5198 0.6696 0.6192
表 6 三个领域 Amazon(A)、Webcam(W)和 DSLR(D)在 Office-31 上的准确率性能。
Model A→W D→W W→D A→D D→A W→A Average
DAN 0.826 0.977 1.00 0.831 0.668 0.666 0.828
8 结论与未来方向 {#sec-8}
DCORAL 0.790 0.980 1.00 0.827 0.653 0.645 0.816
MRAN 0.914 0.969 0.998 0.864 0.683 0.709 0.856
在本文综述中,我们从数据和模型两个视角对迁移学习的机制与策略进行了梳理总结。本文给出了迁移学习的清晰定义,并尝试采用统一的符号体系来描述大量具有代表性的迁移学习方法及相关工作。我们基于数据视角和模型视角,基本阐述了迁移学习的目标与策略:基于数据的视角从数据层面介绍了迁移学习的目标、策略及若干方法;
CDAN 0.931 0.982 1.00 0.898 0.701 0.680 0.865
DANN 0.826 0.978 1.00 0.833 0.668 0.661 0.828
JAN 0.854 0.974 0.998 0.847 0.686 0.700 0.843
CAN 0.945 0.991 0.998 0.950 0.780 0.770 0.906
Baseline 0.616 0.954 0.990 0.638 0.511 0.498 0.701
在 Orgs vs People 任务上表现良好,但在 People vs Places 任务上效果较差。这种现象
基于模型的视角则从模型层面介绍了迁移学习的机制与策略。本文还介绍了迁移学习的应用场景。最后,我们在两个主流领域(目标识别和文本分类)上对代表性迁移学习模型的性能进行了实验评估,并给出了模型之间的对比,结果表明迁移学习模型的选择在实际应用中既是一个重要的研究课题,也是一个复杂的问题。 迁移学习领域未来仍有多个值得关注的研究方向。首先,可以进一步拓展迁移学习技术并将其应用于更广泛的场景,同时需要提出新的方法以应对更复杂情境下的知识迁移问题。例如,在现实场景中,与用户相关的源域数据有时来自其他公司,此时如何在保护用户隐私的同时迁移源域中所蕴含的知识,是一个重要课题。其次,如何度量跨领域的可迁移性并避免负迁移,同样是一个关键问题。尽管已有一些针对负迁移的研究,但负迁移现象仍需进一步开展系统性分析[3]。再次,迁移学习的可解释性也值得深入研究[216]。最后,还应进一步开展理论研究,为迁移学习的有效性与适用性提供理论支撑。作为机器学习中一个备受关注且前景广阔的研究方向,迁移学习相对于传统机器学习具有对数据依赖更少、对标注依赖更低等优势。我们希望本文的工作能够帮助读者更好地理解该领域的研究现状与研究思路。
致谢 {#sec-acknowledgements}
本研究工作得到国家重点研发计划项目(批准号:2018YFB1004300)、国家自然科学基金项目(批准号:U1836206、U1811461、61773361、61836013)以及中国科学院青年创新促进会项目(批准号:2017146)的资助。
参考文献 {-}
[1] D.N. Perkins and G. Salomon, Transfer of Learning. Oxford, England: Pergamon, 1992. [2] S.J. Pan and Q. Yang, “A survey on transfer learning,” IEEE Trans. Knowl. Data Eng., vol. 22, no. 10, pp. 1345–1359, Oct. 2010. [3] Z. Wang, Z. Dai, B. ´Poczos, and J. Carbonell, “Characterizing and avoiding negative transfer,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Long Beach, Jun. 2019, pp. 11293– 11302. [4] K. Weiss, T.M. Khoshgoftaar, and D. Wang, “A survey of transfer learning,” J. Big Data, vol. 3, no. 1, Dec. 2016. [5] J. Huang, A.J. Smola, A. Gretton, K.M. Borgwardt, and B. Sch¨olkopf, “Correcting sample selection bias by unlabeled data,” in Proc. 20th Annual Conference on Neural Information Processing Systems, Vancouver, Dec. 2006, pp. 601–608. [6] M. Sugiyama, T. Suzuki, S. Nakajima, H. Kashima, P. Bnau, and M. Kawanabe, “Direct importance estimation for covariate shift adaptation,” Ann. Inst. Stat. Math., vol. 60, no. 4, pp. 699–746, Dec. 2008. [7] O. Day and T.M. Khoshgoftaar, “A survey on heterogeneous trans- fer learning,” J. Big Data, vol. 4, no. 1, Dec. 2017.
26
[8] M.E. Taylor and P. Stone, “Transfer learning for reinforcement learning domains: A survey,” J. Mach. Learn. Res., vol. 10, pp. 1633– 1685, Sep. 2009. [9] H.B. Ammar, E. Eaton, J.M. Luna, and P. Ruvolo, “Autonomous cross-domain knowledge transfer in lifelong policy gradient rein- forcement learning,” in Proc. 24th International Joint Conference on Artificial Intelligence, Buenos Aires, Jul. 2015, pp. 3345–3351. [10] P. Zhao and S.C.H. Hoi, “OTL: A framework of online transfer learning,” in Proc. 27th International Conference on Machine Learning, Haifa, Jun. 2010, pp. 1231–1238. [11] O. Chapelle, B. Schlkopf, and A. Zien, Semi-supervised Learning. Cambridge: MIT Press, 2010. [12] S. Sun, “A survey of multi-view machine learning,” Neural Com- put. Appl., vol. 23, no. 7–8, pp. 2031–2038, Dec. 2013. [13] C. Xu, D. Tao, and C. Xu, “A survey on multi-view learning,” 2013, arXiv:1304.5634v1. [14] J. Zhao, X. Xie, X. Xu, and S. Sun, “Multi-view learning overview: Recent progress and new challenges,” Inf. Fusion, vol. 38, pp. 43–54, Nov. 2017. [15] D. Zhang, J. He, Y. Liu, L. Si, and R. Lawrence, “Multi-view transfer learning with a large margin approach,” in Proc. 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Diego, Aug. 2011, pp. 1208–1216. [16] P. Yang and W. Gao, “Multi-view discriminant transfer learning,” in Proc. 23rd International Joint Conference on Artificial Intelligence, Beijing, Aug. 2013, pp. 1848–1854. [17] K.D. Feuz and D.J. Cook, “Collegial activity learning between heterogeneous sensors,” Knowl. Inf. Syst., vol. 53, pp. 337–364, Mar. 2017. [18] Y. Zhang and Q. Yang, “An overview of multi-task learning,” Natl. Sci. Rev., vol. 5, no. 1, pp. 30–43, Jan. 2018. [19] W. Zhang, R. Li, T. Zeng, Q. Sun, S. Kumar, J. Ye, and S. Ji, “Deep model based transfer and multi-task learning for biological image analysis,” in Proc. 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Sydney, Aug. 2015, pp. 1475– 1484. [20] A. Liu, N. Xu, W. Nie, Y. Su, and Y. Zhang, “Multi-domain and multi-task learning for human action recognition,” IEEE Trans. Image Process., vol. 28, no. 2, pp. 853–867, Feb. 2019. [21] X. Peng, Z. Huang, X. Sun, and K. Saenko, “Domain agnostic learning with disentangled representations,” in Proc. 36th Interna- tional Conference on Machine Learning, Long Beach, Jun. 2019, pp. 5102–5112. [22] J. Lu, V. Behbood, P. Hao, H. Zuo, S. Xue, and G. Zhang, “Transfer learning using computational intelligence: A survey,” Knowledge- Based Syst., vol. 80, pp. 14–23, May 2015. [23] C. Tan, F. Sun, T. Kong, W. Zhang, C. Yang, and C. Liu, “A Survey on deep transfer learning,” in Proc. 27th International Conference on Artificial Neural Networks, Rhodes, Oct. 2018, pp. 270–279. [24] M. Wang and W. Deng, “Deep visual domain adaptation: A survey,” Neurocomputing, vol. 312, pp. 135–153, Oct. 2018. [25] D. Cook, K.D. Feuz, and N.C. Krishnan, “Transfer learning for activity recognition: A survey,” Knowl. Inf. Syst., vol. 36, no. 3, pp. 537–556, Sep. 2013. [26] L. Shao, F. Zhu, and X. Li, “Transfer learning for visual categoriza- tion: A survey,” IEEE Trans. Neural Netw. Learn. Syst., vol. 26, no. 5, pp. 1019–1034, May 2015. [27] W. Pan, “A survey of transfer learning for collaborative recom- mendation with auxiliary data,” Neurocomputing, vol. 177, pp. 447– 453, Feb. 2016. [28] R. Liu, Y. Shi, C. Ji, and M. Jia, “A Survey of sentiment analysis based on transfer learning,” IEEE Access, vol. 7, pp. 85401–85412, Jun. 2019. [29] Q. Sun, R. Chattopadhyay, S. Panchanathan, and J. Ye, “A two- stage weighting framework for multi-source domain adaptation,” in Proc. 25th Annual Conference on Neural Information Processing Systems, Granada, Dec. 2011, pp. 505–513. [30] M. Belkin, P. Niyogi, and V. Sindhwani, “Manifold regularization: A geometric framework for learning from labeled and unlabeled examples,” J. Mach. Learn. Res., vol. 7, pp. 2399–2434, Nov. 2006. [31] W. Dai, Q. Yang, G. Xue, and Y. Yu, “Boosting for transfer learning,” in Proc. 24th International Conference on Machine Learning, Corvalis, Jun. 2007, pp. 193–200. [32] Y. Freund and R.E. Schapire, “A decision-theoretic generalization of on-line learning and an application to boosting,” J. Comput. Syst. Sci., vol. 55, no. 1, pp. 119–139, Aug. 1997.
27
[33] Y. Yao and G. Doretto, “Boosting for transfer learning with multi- ple sources,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, San Francisco, Jun. 2010, pp. 1855–1862. [34] J. Jiang and C. Zhai, “Instance weighting for domain adaptation in NLP,” in Proc. 45th Annual Meeting of the Association of Computational Linguistics, Prague, Jun. 2007, pp. 264–271. [35] K.M. Borgwardt, A. Gretton, M.J. Rasch, H.-P. Kriegel, B. Scholkopf, and A.J. Smola, “Integrating structured biological data by kernel maximum mean discrepancy,” Bioinformatics, vol. 22, no. 14, pp. 49–57, Jul. 2006. [36] S.J. Pan, I.W. Tsang, J.T. Kwok, and Q. Yang, “Domain adaptation via transfer component analysis,”IEEE Trans. Neural Netw., vol. 22, no. 2, pp. 199–210, Feb. 2011. [37] M. Ghifary, W.B. Kleijn, and M. Zhang, “Domain adaptive neural networks for object recognition,” in Proc. Pacific Rim International Conference on Artificial Intelligence, Gold Coast, Dec. 2014, pp. 898– 904. [38] M. Long, J. Wang, G. Ding, J. Sun, and P.S. Yu, “Transfer feature learning with joint distribution adaptation,”in Proc. IEEE Interna- tional Conference on Computer Vision, Sydney, Dec. 2013, pp. 2200– 2207. [39] M. Long, J. Wang, G. Ding, S.J. Pan, and P.S. Yu, “Adaptation regularization: A general framework for transfer learning,” IEEE Trans. Knowl. Data Eng., vol. 26, no. 5, pp. 1076-1089, May 2014. [40] S. Kullback and R.A. Leibler, “On information and sufficiency,” Ann. Math. Statist., vol. 22, no. 1, pp. 79–86, 1951. [41] W. Dai, G.-R. Xue, Q. Yang, and Y. Yu, “Co-clustering based classification for out-of-domain documents,” in Proc. 13th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Jose, Aug. 2007, pp. 210–219. [42] W. Dai, Q. Yang, G. Xue, and Y. Yu, “Self-taught clustering,” in Proc. 25th International Conference of Machine Learning, Helsinki, Jul. 2008, pp. 200–207. [43] J. Davis and P. Domingos, “Deep transfer via second-order Markov logic,” in Proc. 26th International Conference on Machine Learning, Montreal, Jun. 2009, pp. 217–224. [44] F. Zhuang, X. Cheng, P. Luo, S.J. Pan, and Q. He, “Supervised rep- resentation learning: Transfer learning with deep autoencoders,” in Proc. 24th International Joint Conference on Artificial Intelligence, Buenos Aires, Jul. 2015, pp. 4119–4125. [45] I. Dagan, L. Lee, and F. Pereira, “Similarity-based methods for word sense disambiguation,” in Proc. 35th Annual Meeting of the Association of Computational Linguistics and 8th Conference of the European Chapter of the Association for Computational Linguistics (ACL/EACL), Madrid, Jul. 1997, pp. 56–63. [46] B. Chen, W. Lam, I. Tsang, and T. Wong, “Location and scatter matching for dataset shift in text mining,” in Proc. 10th IEEE International Conference on Data Mining, Sydney, Dec. 2010, pp. 773– 778. [47] S. Dey, S. Madikeri, and P. Motlicek, “Information theoretic clus- tering for unsupervised domain-adaptation,” in Proc. IEEE Interna- tional Conference on Acoustics, Speech and Signal Processing, Shanghai, Mar. 2016, pp. 5580–5584. [48] W.-H. Chen, P.-C. Cho, and Y.-L. Jiang, “Activity recognition using transfer learning,” Sens. Mater., vol. 29, no. 7, pp. 897–904, Jul. 2017. [49] J. Giles, K.K. Ang, L.S. Mihaylova, and M. Arvaneh, “A subject- to-subject transfer learning framework based on Jensen-Shannon divergence for improving brain-computer interface,” in Proc. IEEE International Conference on Acoustics, Speech and Signal Processing, Brighton, May 2019, pp. 3087–3091. [50] L.M. Bregman, “The relaxation method of finding the common point of convex sets and its application to the solution of problems in convex programming,” USSR Comput. Math. Math. Phys., vol. 7, no. 3, pp. 200–217, 1967. [51] S. Si, D. Tao, and B. Geng, “Bregman divergence-based regulariza- tion for transfer subspace learning,”IEEE Trans. Knowl. Data Eng., vol. 22, no. 7, pp. 929–942, Jul. 2010. [52] H. Sun, S. Liu, S. Zhou, and H. Zou, “Unsupervised cross-view semantic transfer for remote sensing image classification,” IEEE Geosci. Remote Sens. Lett., vol. 13, no. 1, pp. 13–17, Jan. 2016. [53] H. Sun, S. Liu, and S. Zhou, “Discriminative subspace alignment for unsupervised visual domain adaptation,” Neural Process. Lett., vol. 44, no. 3, pp. 779–793, Dec. 2016. [54] Q. Shi, Y. Zhang, X. Liu, and K. Zhao, “Regularised transfer learning for hyperspectral image classification,” IET Comput. Vis., vol. 13, no. 2, pp. 188–193, Feb. 2019.
[55] A. Gretton, O. Bousquet, A.J. Smola, and B. Schlkopf, “Measuring statistical dependence with Hilbert-Schmidt norms,” in Proc. 18th International Conference on Algorithmic Learning Theory, Singapore, Oct. 2005, pp. 63–77. [56] H. Wang and Q. Yang, “Transfer learning by structural analogy,” in Proc. 25th AAAI Conference on Artificial Intelligence, San Francisco, Aug. 2011, pp. 513–518. [57] M. Xiao and Y. Guo, “Feature space independent semi-supervised domain adaptation via kernel matching,”IEEE Trans. Pattern Anal. Mach. Intell., vol. 37, no. 1, pp. 54–66, Jan. 2015. [58] K. Yan, L. Kou, and D. Zhang, “Learning domain-invariant sub- space using domain features and independence maximization,” IEEE T. Cybern., vol. 48, no. 1, pp. 288–299, Jan. 2018. [59] J. Shen, Y. Qu, W. Zhang, and Y. Yu, “Wasserstein distance guided representation learning for domain adaptation,” in Proc. 32nd AAAI Conference on Artificial Intelligence, New Orleans, Feb. 2018, pp. 4058–4065. [60] C.-Y. Lee, T. Batra, M.H. Baig, and D. Ulbricht, “Sliced Wasserstein discrepancy for unsupervised domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Long Beach, Jun. 2019, pp. 10285–10295. [61] W. Zellinger, T. Grubinger, E. Lughofer, T. Natschlger, and S. Saminger-Platz, “Central moment discrepancy (CMD) for domain- invariant representation learning,” in Proc. 5th International Confer- ence on Learning Representations, Toulon, Apr. 2017, pp. 1–13. [62] A. Gretton, D. Sejdinovic, H. Strathmann, S. Balakrishnan, M. Pon- til, K. Fukumizu, and B.K. Sriperumbudur, “Optimal kernel choice for large-scale two-sample tests,” in Proc. 26th Annual Conference on Neural Information Processing Systems, Lake Tahoe, Dec. 2012, pp. 1205–1213. [63] H. Yan, Y. Ding, P. Li, Q. Wang, Y. Xu, and W. Zuo, “Mind the class weight bias: Weighted maximum mean discrepancy for unsu- pervised domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Honolulu, Jul. 2017, pp. 2272–2281. [64] H. Daum´e III, “Frustratingly easy domain adaptation,” in Proc. 45th Annual Meeting of the Association for Computational Linguistics, Prague, Jun. 2007, pp. 256–263. [65] H. Daum´e III, A. Kumar, and A. Saha, “Co-regularization based semi-supervised domain adaptation,” in Proc. 24th Annual Confer- ence on Neural Information Processing Systems, Vancouver, Dec. 2010, pp. 478–486. [66] L. Duan, D. Xu, and I.W. Tsang, “Learning with augmented features for heterogeneous domain adaptation,” in Proc. 29th Inter- national Conference on Machine Learning, Edinburgh, Jun. 2012, pp. 1–8. [67] W. Li, L. Duan, D. Xu, and I.W. Tsang, “Learning with augmented features for supervised and semi-supervised heterogeneous do- main adaptation,” IEEE Trans. Pattern Anal. Mach. Intell., vol. 36, no. 6, pp. 1134–1148, Jun. 2014. [68] K.I. Diamantaras and S.Y. Kung, Principal Component Neural Net- works. New York: Wiley, 1996. [69] B. Schlkopf, A. Smola, and K. Mller, “Nonlinear component anal- ysis as a kernel eigenvalue problem,” Neural Comput., vol. 10, no. 5, pp. 1299–1319, Jul. 1998. [70] J. Wang, Y. Chen, S. Hao, W. Feng, and Z. Shen, “Balanced distribution adaptation for transfer learning,” in Proc. 17th IEEE International Conference on Data Mining, New Orleans, Nov. 2017, pp. 1129–1134. [71] A. Blum and T. Mitchell, “Combining labeled and unlabeled data with co-training,” in Proc. 11th Annual Conference on Computational Learning Theory, Madison, Jul. 1998, pp. 92–100. [72] M. Chen, K.Q. Weinberger, and J.C. Blitzer, “Co-training for domain adaptation,” in Proc. 25th Annual Conference on Neural Information Processing Systems, Granada, Dec. 2011, pp. 2456–2464. [73] Z.-H. Zhou and M. Li, “Tri-training: Exploiting unlabeled data using three classifiers,” IEEE Trans. Knowl. Data Eng., vol. 17, no. 11, pp. 1529–1541, Nov. 2005. [74] K. Saito, Y. Ushiku, and T. Harada, “Asymmetric tri-training for unsupervised domain adaptation,” in Proc. 34th International Conference on Machine Learning, Sydney, Aug. 2017, pp. 2988–2997. [75] S.J. Pan, J.T. Kwok, and Q. Yang, “Transfer learning via dimen- sionality reduction,” in Proc. 23rd AAAI Conference on Artificial Intelligence, Chicago, Jul. 2008, pp. 677–682. [76] K.Q. Weinberger, F. Sha, and L.K. Saul, “Learning a kernel matrix for nonlinear dimensionality reduction,” in Proc. 21st International Conference on Machine Learning, Banff, Jul. 2004, pp. 106–113.
28
[77] L. Vandenberghe and S. Boyd, “Semidefinite programming,” SIAM Rev., vol. 38, no. 1, pp. 49–95, Mar. 1996. [78] S.J. Pan, I.W. Tsang, J.T. Kwok, and Q. Yang, “Domain adaptation via transfer component analysis,” in Proc. 21st International Joint Conference on Artificial Intelligence, Pasadena, Jul. 2009, pp. 1187– 1192. [79] C. Hou, Y.H. Tsai, Y. Yeh, and Y.F. Wang, “Unsupervised domain adaptation with label and structural consistency,” IEEE Trans. Image Process., vol. 25, no. 12, pp. 5552–5562, Dec. 2016. [80] J. Tahmoresnezhad and S. Hashemi, “Visual domain adaptation via transfer feature learning,” Knowl. Inf. Syst., vol. 50, no. 2, pp. 585–605, Feb. 2017. [81] J. Zhang, W. Li, and P. Ogunbona, “Joint geometrical and statistical alignment for visual domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Honolulu, Jul. 2017, pp. 5150–5158. [82] B. Schlkopf, R. Herbrich, and A.J. Smola, “A generalized repre- senter theorem,” in Proc. International Conference on Computational Learning Theory, Amsterdam, Jul. 2001, pp. 416–426. [83] L. Duan, I.W. Tsang, and D. Xu, “Domain transfer multiple kernel learning,” IEEE Trans. Pattern Anal. Mach. Intell., vol. 34, no. 3, pp. 465–479, Mar. 2012. [84] A. Rakotomamonjy, F.R. Bach, S. Canu, and Y. Grandvalet, “Sim- pleMKL,” J. Mach. Learn. Res., vol. 9, pp. 2491-2521, Nov. 2008. [85] I.S. Dhillon, S. Mallela, and D.S. Modha, “Information-theoretic co-clustering,” in Proc. 9th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Washington, Aug. 2003, pp. 89–98. [86] S. Deerwester, S.T. Dumais, G.W. Furnas, T.K. Landauer, and R. Harshman, “Indexing by latent semantic analysis,” J. Am. Soc. Inf. Sci., vol. 41, pp. 391–407, Sep. 1990. [87] T. Hofmann, “Probabilistic latent semantic analysis,” in Proc. 15th Conference on Uncertainty in Artificial Intelligence, Stockholm, Jul. 1999, pp. 289–296. [88] J. Yoo and S. Choi, “Probabilistic matrix tri-factorization,” in Proc. IEEE International Conference on Acoustics, Speech, and Signal Processing, Taipei, Apr. 2009, pp. 1553–1556. [89] A. Dempster, N. Laird, and D. Rubin, “Maximum likelihood from incomplete data via the EM algorithm,” J. R. Stat. Soc. - Ser. B, vol. 39, no. 1, pp. 1–38, 1977. [90] G.-R. Xue, W. Dai, Q. Yang, and Y. Yu, “Topic-bridged PLSA for cross-domain text classification,” in Proc. 31st Annual International ACM SIGIR Conference on Research and Development in Information Retrieval, Singapore, Jul. 2008, pp. 627–634. [91] F. Zhuang, P. Luo, Z. Shen, Q. He, Y. Xiong, Z. Shi, and H. Xiong, “Collaborative Dual-PLSA: Mining distinction and commonality across multiple domains for text classification,” in Proc. 19th ACM International Conference on Information and Knowledge Management, Toronto, Oct. 2010, pp. 359–368. [92] F. Zhuang, P. Luo, Z. Shen, Q. He, Y. Xiong, Z. Shi, and H. Xiong, “Mining distinction and commonality across multiple domains using generative model for text classification,” IEEE Trans. Knowl. Data Eng., vol. 24, no. 11, pp. 2025–2039, Nov. 2012. [93] F. Zhuang, P. Luo, P. Yin, Q. He, and Z. Shi, “Concept learn- ing for cross-domain text classification: A general probabilistic framework,” in Proc. 23rd International Joint Conference on Artificial Intelligence, Beijing, Aug. 2013, pp. 1960–1966. [94] J. Blitzer, R. McDonald, and F. Pereira, “Domain adaptation with structural correspondence learning,” in Proc. Conference on Empirical Methods in Natural Language Processing, Sydney, Jul. 2006, pp. 120– 128. [95] R.K. Ando and T. Zhang, “A framework for learning predictive structures from multiple tasks and unlabeled data,” J. Mach. Learn. Res., vol. 6, pp. 1817–1853, Dec. 2005. [96] X. Glorot, A. Bordes, and Y. Bengio, “Domain adaptation for large-scale sentiment classification: A deep learning approach,” in Proc. 28th International Conference on Machine Learning, Bellevue, Jun. 2011, pp. 513–520. [97] P. Vincent, H. Larochelle, Y. Bengio, and P.-A. Manzagol, “Extract- ing and composing robust features with denoising autoencoders,” in Proc. 25th International Conference on Machine Learning, Helsinki, Jul. 2008, pp. 1096–1103. [98] M. Chen, Z. Xu, K. Weinberger, and F. Sha, “Marginalized denois- ing autoencoders for domain adaptation,” in Proc. 29th International Conference on Machine Learning, Edinburgh, Jun. 2012, pp. 767–774.
[99] M. Chen, K.Q. Weinberger, Z. Xu, and F. Sha, “Marginalizing stacked linear denoising autoencoders,” J. Mach. Learn. Res., vol. 16, no. 1, pp. 3849–3875, Jan. 2015. [100] B. Fernando, A. Habrard, M. Sebban, and T. Tuytelaars, “Unsu- pervised visual domain adaptation using subspace alignment,” in Proc. IEEE International Conference on Computer Vision, Sydney, Dec. 2013, pp. 2960–2967. [101] B. Sun and K. Saenko, “Subspace distribution alignment for unsupervised domain adaptation,” in Proc. British Machine Vision Conference, Swansea, Sep. 2015, pp. 24.1–24.10. [102] B. Gong, Y. Shi, F. Sha, and K. Grauman, “Geodesic flow kernel for unsupervised domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Providence, Jun. 2012, pp. 2066–2073. [103] R. Gopalan, Ruonan Li, and R. Chellappa, “Domain adaptation for object recognition: An unsupervised approach,” in Proc. IEEE International Conference on Computer Vision, Barcelona, Jun. 2011, pp. 999-1006. [104] M.I. Zelikin, Control Theory and Optimization I in Encyclopaedia of Mathematical Sciences, vol. 86, Berlin: Springer, 2000. [105] B. Sun, J. Feng, and K. Saenko, “Return of frustratingly easy domain adaptation,” in Proc. 30th AAAI Conference on Artificial Intelligence, Phoenix, Feb. 2016, pp. 2058–2065. [106] S.J. Pan, X. Ni, J.-T. Sun, Q. Yang, and Z. Chen, “Cross-domain sentiment classification via spectral feature alignment,” in Proc. 19th International Conference on World Wide Web, Raleigh, Apr. 2010, pp. 751–760. [107] J. Blitzer, M. Dredze, and F. Pereira, “Biographies, bollywood, boom-boxes and blenders: Domain adaptation for sentiment classi- fication,” in Proc. 45th Annual Meeting of the Association of Computa- tional Linguistics, Prague, Jun. 2007, pp. 440–447. [108] F.R.K. Chung, Spectral Graph Theory. Providence: American Math- ematical Society, 1997. [109] A.Y. Ng, M.I. Jordan, and Y. Weiss, “On spectral clustering: Analysis and an algorithm,” in Proc. 15th Annual Conference on Neural Information Processing Systems, Vancouver, Dec. 2001, pp. 849- 856. [110] X. Ling, W. Dai, G.-R. Xue, Q. Yang, and Y. Yu, “Spectral domain- transfer learning,” in Proc. 14th ACM SIGKDD International Confer- ence on Knowledge Discovery and Data Mining, Las Vegas, Aug. 2008, pp. 488–496. [111] S.D. Kamvar, D. Klein, and C.D. Manning, “Spectral learning,” in Proc. 18th International Joint Conference on Artificial Intelligence, Acapulco, Aug. 2003, pp. 561–566. [112] J. Shi and J. Malik, “Normalized cuts and image segmentation,” IEEE Trans. Pattern Anal. Mach. Intell., vol .22, no. 8, pp. 888–905, Aug. 2000. [113] L. Duan, I.W. Tsang, D. Xu, and T.-S. Chua, “Domain adaptation from multiple sources via auxiliary classifiers,” in Proc. 26th In- ternational Conference on Machine Learning, Montreal, Jun. 2009, pp. 289–296. [114] L. Duan, D. Xu, and I.W. Tsang, “Domain adaptation from multiple sources: A domain-dependent regularization approach,” IEEE Trans. Neural Netw. Learn. Syst., vol. 23, no. 3, pp. 504–518, Mar. 2012. [115] P. Luo, F. Zhuang, H. Xiong, Y. Xiong, and Q. He, “Transfer learn- ing from multiple source domains via consensus regularization,” in Proc. 17th ACM Conference on Information and Knowledge Management, Napa Valley, Oct. 2008, pp. 103–112. [116] F. Zhuang, P. Luo, H. Xiong, Y. Xiong, Q. He, and Z. Shi, “Cross- domain learning from multiple sources: A consensus regularization perspective,” IEEE Trans. Knowl. Data Eng., vol. 22, no. 12, pp. 1664– 1678, Dec. 2010. [117] T. Evgeniou, C.A. Micchelli, and M. Pontil, “Learning multiple tasks with kernel methods,” J. Mach. Learn. Res., vol. 6, pp. 615-637, Apr. 2005. [118] T. Kato, H. Kashima, M. Sugiyama, and K. Asai, “Multi-task learning via conic programming,” in Proc. 21st Annual Conference on Neural Information Processing Systems, Vancouver, Dec. 2007, pp. 737–744. [119] A.J. Smola and B. Schlkopf, “A tutorial on support vector regres- sion,” Stat. Comput., vol. 14, no. 3, pp. 199–222, Aug. 2004. [120] J. Weston, R. Collobert, F. Sinz, L. Bottou, and V. Vapnik, “Infer- ence with the universum,” in Proc. 23rd International Conference on Machine Learning, Pittsburgh, Jun. 2006, pp. 1009–1016. [121] X. Yu and Y. Aloimonos, “Attribute-based transfer learning for object categorization with zero/one training example,” in Proc.
29
European Conference on Computer Vision, Heraklion, Sep. 2010, pp. 127–140. [122] F. Zhuang, P. Luo, H. Xiong, Q. He, Y. Xiong, and Z. Shi, “Ex- ploiting associations between word clusters and document classes for cross-domain text categorization,” Stat. Anal. Data Min., vol. 4, no. 1, pp. 100–114, Feb. 2011. [123] F. Zhuang, P. Luo, C. Du, Q. He, Z. Shi, and H. Xiong, “Triplex transfer learning: Exploiting both shared and distinct concepts for text classification,” IEEE T. Cybern., vol. 44, no. 7, pp. 1191–1203, Jul. 2014. [124] M. Long, J. Wang, G. Ding, W. Cheng, X. Zhang, and W. Wang, “Dual transfer learning,” in Proc. 12th SIAM International Conference on Data Mining, Anaheim, Apr. 2012, pp. 540–551. [125] H. Wang, F. Nie, H. Huang, and C. Ding, “Dyadic transfer learn- ing for cross-domain image classification,” in Proc. International Conference on Computer Vision, Barcelona, Nov. 2011, pp. 551–556. [126] D. Wang, C. Lu, J. Wu, H. Liu, W. Zhang, F. Zhuang, and H. Zhang, “Softly associative transfer learning for cross- domain classification,” IEEE T. Cybern., to be published. doi: 10.1109/TCYB.2019.2891577. [127] Q. Do, W. Liu, J. Fan, and D. Tao, “Unveiling hidden implicit similarities for cross-domain recommendation,” IEEE Trans. Knowl. Data Eng., to be published. doi: 10.1109/TKDE.2019.2923904. [128] T. Tommasi and B. Caputo, “The more you know, the less you learn: from knowledge transfer to one-shot learning of object categories” in Proc. British Machine Vision Conference, London, Sep. 2009, pp. 80.1–80.11. [129] G.C. Cawley, “Leave-one-out cross-validation based model selec- tion criteria for weighted LS-SVMs,” in Proc. IEEE International Joint Conference on Neural Network, Vancouver, Jul. 2006, pp. 1661–1668. [130] T. Tommasi, F. Orabona, and B. Caputo, “Safety in numbers: Learning categories from few examples with multi model knowl- edge transfer,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, San Francisco, Jun. 2010, pp. 3081–3088. [131] C.-K. Lin, Y.-Y. Lee, C.-H. Yu, and H.-H. Chen, “Exploring ensemble of models in taxonomy-based cross-domain sentiment classification,” in Proc. 23rd ACM International on Conference on Information and Knowledge Management, Shanghai, Nov. 2014, pp. 1279–1288. [132] J. Gao, W. Fan, J. Jiang, and J. Han, “Knowledge transfer via mul- tiple model local structure mapping,” in Proc. 14th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Las Vegas, Aug. 2008, pp. 283–291. [133] F. Zhuang, P. Luo, S.J. Pan, H. Xiong, and Q. He. “Ensemble of anchor adapters for transfer learning,” in Proc. 25th ACM In- ternational on Conference on Information and Knowledge Management, Indianapolis, Oct. 2016, pp. 2335–2340. [134] F. Zhuang, X. Cheng, P. Luo, S.J. Pan, and Q. He, “Supervised representation learning with double encoding-layer autoencoder for transfer learning,” ACM Trans. Intell. Syst. Technol., vol. 9, no. 2, pp. 1–17, Jan. 2018. [135] M. Ghifary, W.B. Kleijn, and M. Zhang, “Domain adaptive neural networks for object recognition,” in Proc. 13th Pacific Rim Interna- tional Conference on Artificial Intelligence, Gold Coast, Dec. 2014, pp. 898–904. [136] E. Tzeng, J. Hoffman, N. Zhang, K. Saenko, and T. Darrell, “Deep domain confusion: Maximizing for domain invariance,” 2014, arXiv:1412.3474v1. [137] M. Long, Y. Cao, J. Wang, and M.I. Jordan, “Learning transferable features with deep adaptation networks,” in Proc. 32nd International Conference on Machine Learning, Lille, Jul. 2015, pp. 97–105. [138] A. Krizhevsky, I. Sutskever, and G.E. Hinton, “Imagenet classi- fication with deep convolutional neural networks,” in Proc. 26th Annual Conference on Neural Information Processing Systems, Lake Tahoe, Dec. 2012, pp. 1097–1105. [139] I. Goodfellow, J. Pouget-Abadie, M. Mirza, B. Xu, D. Warde- Farley, S. Ozair, A. Courville, and Y. Bengio, “Generative adver- sarial nets,” in Proc. 28th Annual Conference on Neural Information Processing Systems, Montreal, Dec. 2014, pp. 2672–2680. [140] J. Yosinski, J. Clune, Y. Bengio, and H. Lipson, “How transferable are features in deep neural networks?” in Proc. 28th Annual Confer- ence on Neural Information Processing Systems, Montreal, Dec. 2014, pp. 3320–3328. [141] M. Long, Y. Cao, Z. Cao, J. Wang, and M.I. Jordan, “Trans- ferable representation learning with deep adaptation networks,” IEEE Trans. Pattern Anal. Mach. Intell., to be published. doi: 10.1109/TPAMI.2018.2868685.
[142] Y. Grandvalet and Y. Bengio, “Semi-supervised learning by en- tropy minimization,” in Proc. 18th Annual Conference on Neural Information Processing Systems, Vancouver, Dec. 2004, pp. 529–536. [143] C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke, and A. Rabinovich, “Going deeper with convolutions,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Boston, Jun. 2015, pp. 1–9. [144] K. He, X. Zhang, S. Ren, and J. Sun, “Deep residual learning for image recognition,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Las Vegas, Jun. 2016, pp. 770–778. [145] K.P. Chwialkowski, A. Ramdas, D. Sejdinovic, and A. Gretton, “Fast two-sample testing with analytic representations of probabil- ity measures,” in Proc. 29th Annual Conference on Neural Information Processing Systems, Montreal, Dec. 2015, pp. 1981–1989. [146] M. Long, H. Zhu, J. Wang, and M.I. Jordan, “Unsupervised do- main adaptation with residual transfer networks,” in Proc. 30th An- nual Conference on Neural Information Processing Systems, Barcelona, Dec. 2016, pp. 136–144. [147] M. Long, H. Zhu, J. Wang, and M.I. Jordan, “Deep transfer learning with joint adaptation networks,” in Proc. 34th International Conference on Machine Learning, Sydney, Aug. 2017, pp. 2208–2217. [148] B. Sun and K. Saenko, “Deep CORAL: Correlation alignment for deep domain adaptation,” in Proc. European Conference on Computer Vision Workshops, Amsterdam, Oct. 2016, pp. 443–450. [149] C. Chen, Z. Chen, B. Jiang, and X. Jin, “Joint domain alignment and discriminative feature learning for unsupervised deep domain adaptation,” in Proc. 33rd AAAI Conference on Artificial Intelligence, Honolulu, Jan. 2019, pp. 3296–3303. [150] Y. Pan, T. Yao, Y. Li, Y. Wang, C.-W. Ngo, and T. Mei, “Trans- ferrable prototypical networks for unsupervised domain adap- tation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Long Beach, Jun. 2019, pp. 2239–2247. [151] G. Kang, L. Jiang, Y. Yang, and A.G. Hauptmann, “Contrastive adaptation network for unsupervised domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Long Beach, Jun. 2019, pp. 4893–4902. [152] Y. Zhu, F. Zhuang, J. Wang, J. Chen, Z. Shi, W. Wu, and Q. He, “Multi-representation adaptation network for cross-domain image classification,” Neural Netw., vol. 119. pp. 214–221, Nov. 2019. [153] Y. Zhu, F. Zhuang, and D. Wang, “Aligning domain-specific dis- tribution and classifier for cross-domain classification from multiple sources,” in Proc. 33rd AAAI Conference on Artificial Intelligence, Honolulu, Jan. 2019, pp. 5989–5996. [154] Y. Ganin and V. Lempitsky, “Unsupervised domain adaptation by backpropagation,” in Proc. 32nd International Conference on Machine Learning, Lille, Jul. 2015, pp. 1180–1189. [155] Y. Ganin, E. Ustinova, H. Ajakan, P. Germain, H. Larochelle, F.Laviolette, M. Marchand, and V. Lempitsky, “Domain-adversarial training of neural networks,” J. Mach. Learn. Res., vol. 17, pp. 1–35, Apr. 2016. [156] E. Tzeng, J. Hoffman, K. Saenko, and T. Darrell, “Adversarial discriminative domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Honolulu, Jul. 2017, pp. 2962–2971. [157] J. Hoffman, E. Tzeng, T. Park, J.-Y. Zhu, P. Isola, K. Saenko, A.A. Efros, and T. Darrell, “CyCADA: Cycle-consistent adversarial domain adaptation,” in Proc. 35th International Conference on Machine Learning, Stockholm, Jul. 2018, pp. 1994–2003. [158] M. Long, Z. Cao, J. Wang, and M.I. Jordan, “Conditional adver- sarial domain adaptation,” in Proc. 32nd Annual Conference on Neural Information Processing Systems, Montreal, Dec. 2018, pp. 1640–1650. [159] Y. Zhang, H. Tang, K. Jia, and M. Tan, “Domain-symmetric net- works for adversarial domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Long Beach, Jun. 2019, pp. 5031–5040. [160] H. Zhao, S. Zhang, G. Wu, J.M.F. Moura, J.P. Costeira, and G.J. Gordon, “Adversarial multiple source domain adaptation,” in Proc. 32nd Annual Conference on Neural Information Processing Systems, Montreal, Dec. 2018, pp. 8559–8570. [161] C. Yu, J. Wang, Y. Chen, and M. Huang, “Transfer learning with dynamic adversarial adaptation network,” in Proc. 19th IEEE International Conference on Data Mining, Beijing, Nov. 2019, pp. 1–9. [162] J. Zhang, Z. Ding, W. Li, and P. Ogunbona, “Importance weighted adversarial nets for partial domain adaptation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Salt Lake City, Jun. 2018, pp. 8156–8163.
30
[163] Z. Cao, M. Long, J. Wang, and M.I. Jordan, “Partial transfer learn- ing with selective adversarial networks,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Salt Lake City, Jun. 2018, pp. 2724–2732. [164] B. Wang, M. Qiu, X. Wang, Y. Li, Y. Gong, X. Zeng, J. Huang, B. Zheng, D. Cai, and J. Zhou, “A minimax game for instance based selective transfer learning,” in Proc. 25th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Anchorage, Aug. 2019, pp. 34–43. [165] X. Chen, S. Wang, M. Long, and J. Wang, “Transferability vs. discriminability: Batch spectral penalization for adversarial domain adaptation,” in Proc. 36th International Conference on Machine Learn- ing, Long Beach, Jun. 2019, pp. 1081–1090. [166] J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li, and L. Fei-Fei, “ImageNet: A large-scale hierarchical image database,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition, Miami, Jun. 2009, pp. 248–255. [167] M. Maqsood, F. Nazir, U. Khan, F. Aadil, H. Jamal, I. Mehmood, and O. Song, “Transfer learning assisted classification and detection of Alzheimer’s disease stages using 3D MRI scans,” Sensors, vol. 19, no. 11, pp. 1–19, Jun. 2019. [168] D.S. Marcus, A.F. Fotenos, J.G. Csernansky, J.C. Morris, and R.L. Buckner, “Open access series of imaging studies: Longitudinal MRI data in nondemented and demented older adults,”J. Cogn. Neurosci., vol. 22, no. 12, pp. 2677–2684, Dec. 2010. [169] H.-C. Shin, H.R. Roth, M. Gao, L. Lu, Z. Xu, I. Nogues, J. Yao, D. Mollura, and R.M. Summers, “Deep convolutional neural networks for computer-aided detection: CNN architectures, dataset characteristics and transfer Learning,” IEEE Trans. Med. Imaging, vol. 35, no. 5, pp. 1285–1298, May 2016. [170] M. Byra, M. Wu, X. Zhang, H. Jang, Y.-J. Ma, E.Y. Chang, S. Shah, and Jiang Du, “Knee menisci segmentation and relaxometry of 3D ultrashort echo time cones MR imaging using attention UNet with transfer learning,” Magn. Reson. Med., Sep. 2019, doi: 10.1002/mrm.27969. [171] X. Tang, B. Du, J. Huang, Z. Wang, and L. Zhang, “On combining active and transfer learning for medical data classification,” IET Comput. Vis., vol. 13, no. 2, pp. 194–205, Feb. 2019. [172] M. Zeng, M. Li, Z. Fei, Y. Yu, Y. Pan, and J. Wang, “Automatic ICD-9 coding via deep transfer learning,” Neurocomputing, vol. 324, pp. 43–50, Jan. 2019. [173] G. Schweikert, G. Ratsch, C. Widmer, and B. Scholkopf, “An empirical analysis of domain adaptation algorithms for genomic sequence analysis,” in Proc. 22nd Annual Conference on Neural Infor- mation Processing Systems, Vancouver, Dec. 2008, pp. 1433–1440. [174] R. Petegrosso, S. Park, T.H. Hwang, and R. Kuang, “Transfer learning across ontologies for phenome-genome association predic- tion,” Bioinformatics, vol. 33, no. 4, pp. 529–536, Feb. 2017. [175] T. Hwang and R. Kuang, “A heterogeneous label propagation al- gorithm for disease gene discovery,” in Proc. 10th SIAM International Conference on Data Mining, Columbus, Apr. 2010, pp. 583–594. [176] Q. Xu, E.W. Xiang, and Q. Yang, “Protein-protein interaction prediction via collective matrix factorization,” in Proc. IEEE Interna- tional Conference on Bioinformatics and Biomedicine, Hong Kong, Dec. 2010, pp. 62–67. [177] A.P. Singh and G.J. Gordon, “Relational learning via collective matrix factorization,” in Proc. 14th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Las Vegas, Aug. 2008, pp. 650–658. [178] S. Di, H. Zhang, C. Li, X. Mei, D. Prokhorov, and H. Ling, “Cross- domain traffic scene understanding: A dense correspondence-based transfer learning approach,” IEEE Trans. Intell. Transp. Syst., vol. 19, no. 3, pp. 745–757, Mar. 2018. [179] H. Abdi, “Partial least squares regression and projection on latent structure regression (PLS Regression),” Wiley Interdiscip. Rev.- Comput. Statist., vol. 2, no. 1, pp. 97106, Jan. 2010. [180] S.D. Pietra, V.D. Pietra, and J. Lafferty, “Inducing features of random fields,” IEEE Trans. Pattern Anal. Mach. Intell., vol. 19, no. 4, pp. 380–393, Apr. 1997. [181] C. Liu, J. Yuen, and A. Torralba, “Nonparametric scene parsing via label transfer,” IEEE Trans. Pattern Anal. Mach. Intell., vol. 33, no. 12, pp. 2368–2382, Dec. 2011. [182] C. Lu, F. Hu, D. Cao, J. Gong, Y. Xing, and Z. Li, “Transfer learning for driver model adaptation in lane-changing scenarios using manifold alignment,” IEEE Trans. Intell. Transp. Syst., to be published. doi: 10.1109/TITS.2019.2925510.
[183] D.J. Berndt and J. Clifford, “Using dynamic time warping to find patterns in time series,” in Proc. Knowledge Discovery in Databases Workshop, Seattle, Jul. 1994, pp. 359–370. [184] N. Makondo, M. Hiratsuka, B. Rosman, and O. Hasegawa, “A non-linear manifold alignment approach to robot learning from demonstrations,” J. Robot. Mechatron., vol. 30, no. 2, pp. 265–281, Apr. 2018. [185] P. Angkititrakul, C. Miyajima, and K. Takeda, “Modeling and adaptation of stochastic driver-behavior model with application to car following,” in Proc. IEEE Intelligent Vehicles Symposium (IV), Baden-Baden, Jun. 2011, pp. 814–819. [186] Y. Liu, P. Lasang, S. Pranata, S. Shen, and W. Zhang, “Driver pose estimation using recurrent lightweight network and virtual data augmented transfer learning,” IEEE Trans. Intell. Transp. Syst., vol. 20, no. 10, pp. 3818–3831, Oct. 2019. [187] J. Wang, H. Zheng, Y. Huang, and X. Ding, “Vehicle type recog- nition in surveillance images from labeled web-nature data using deep transfer learning,” IEEE Trans. Intell. Transp. Syst., vol. 19, no. 9, pp. 2913–2922, Sep. 2018. [188] K. Gopalakrishnan, S.K. Khaitan, A. Choudhary, and A. Agrawal, “Deep convolutional neural networks with transfer learning for computer vision-based data-driven pavement distress detection,” Constr. Build. Mater., vol. 157, pp. 322–330, Dec. 2017. [189] S. Bansod and A. Nandedkar, “Transfer learning for video anomaly detection,” J. Intell. Fuzzy Syst., vol. 36, no. 3, pp. 1967– 1975, Mar. 2019. [190] G. Rosario, T. Sonderman, and X. Zhu, “Deep transfer learning for traffic sign recognition,” in Proc. IEEE International Conference on Information Reuse and Integration, Salt Lake City, Jul. 2018, pp. 178–185. [191] W. Pan, E.W. Xiang, and Q. Yang, “Transfer learning in collabora- tive filtering with uncertain ratings,” in Proc. 26th AAAI Conference on Artificial Intelligence, Toronto, Jul. 2012, pp. 662–668. [192] G. Hu, Y. Zhang, and Q. Yang, “Transfer meets hybrid: A synthetic approach for cross-domain collaborative filtering with text,” in Proc. 28th International Conference on World Wide Web, San Francisco, May 2019, pp. 2822–2829. [193] W. Pan, E.W. Xiang, N.N. Liu, and Q. Yang, “Transfer learning in collaborative filtering for sparsity reduction,” in Proc. 24th AAAI Conference on Artificial Intelligence, Atlanta, Jul. 2010, pp. 230–235. [194] W. Pan and Q. Yang, “Transfer learning in heterogeneous col- laborative filtering domains,” Artif. Intell., vol. 197, pp. 39–55, Apr. 2013. [195] F. Zhuang, Y. Zhou, F. Zhang, X. Ao, X. Xie, and Q. He, “Sequen- tial transfer learning: Cross-domain novelty seeking trait mining for recommendation,” in Proc. 26th International Conference on World Wide Web Companion, Perth, Apr. 2017, pp. 881–882. [196] J. Zheng, F. Zhuang, and C. Shi, “Local ensemble across multiple sources for collaborative filtering,” in Proc. 26th ACM International on Conference on Information and Knowledge Management, Singapore, Nov. 2017, pp. 2431–2434. [197] F. Zhuang, J. Zheng, J. Chen, X. Zhang, C. Shi, and Q. He, “Transfer collaborative filtering from multiple sources via consen- sus regularization,” Neural Netw., vol. 108, pp. 287–295, Dec. 2018. [198] J. He, R. Liu, F. Zhuang, F. Lin, C. Niu, and Q. He, “A general cross-domain recommendation framework via Bayesian neural net- work,” in Proc. 18th IEEE International Conference on Data Mining, Singapore, Nov. 2018, pp. 1001–1006. [199] F. Zhu, Y. Wang, C. Chen, G. Liu, M.A. Orgun, and J. Wu, “A deep framework for cross-domain and cross-system recommendations,” in Proc. 27th International Joint Conference on Artificial Intelligence, Stockholm, Jul. 2018, pp. 3711–3717. [200] F. Yuan, L. Yao, and B. Benatallah, “DARec: Deep domain adap- tation for cross-domain recommendation via transferring rating patterns,” in Proc. 29th International Joint Conference on Artificial Intelligence, Macao, Aug. 2019, pp. 4227–4233. [201] E. Bastug, M. Bennis, and M. Debbah, “A transfer learning approach for cache-enabled wireless networks,” in Proc. 13th Inter- national Symposium on Modeling and Optimization in Mobile, Ad Hoc, and Wireless Networks, Mumbai, May 2015, pp. 161–166. [202] R. Li, Z. Zhao, X. Chen, J. Palicot, and H. Zhang, “TACT: A transfer actor-critic learning framework for energy saving in cel- lular radio access networks,” IEEE Trans. Wirel. Commun., vol. 13, no. 4, pp. 2000–2011, Apr. 2014. [203] Q. Zhao and D. Grace, “Transfer learning for QoS aware topology management in energy efficient 5G cognitive radio networks,” in
31
Proc. 1st International Conference on 5G for Ubiquitous Connectivity, Akaslompolo, Nov. 2014, pp. 152–157. [204] B. Guo, J. Li, V.W. Zheng, Z. Wang, and Z. Yu, “Citytransfer: Transferring inter- and intra-city knowledge for chain store site recommendation based on multi-source urban data,” in Proc. ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies, Jan. 2018, pp. 1–23. [205] Y. Wei, Y. Zheng, and Q. Yang, “Transfer knowledge between cities,” in Proc. 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco, Aug. 2016, pp. 1905–1914. [206] U. Cote-Allard, C.L. Fall, A. Drouin, A. Campeau-Lecours, C. Gosselin, K. Glette, F. Laviolette, and B. Gosselin, “Deep learn- ing for electromyographic hand gesture signal classification using transfer learning,” IEEE Trans. Neural Syst. Rehabil. Eng., vol. 27, no. 4, pp. 760–771, Apr. 2019. [207] C. Ren, D. Dai, K. Huang, and Z. Lai, “Transfer learning of structured representation for face recognition,” IEEE Trans. Image Process., vol. 23, no. 12, pp. 5440–5454, Dec. 2014. [208] J. Wang, Y. Chen, L. Hu, X. Peng, and P.S. Yu, “Stratified trans- fer learning for cross-domain activity recognition,” in Proc. IEEE International Conference on Pervasive Computing and Communications, Athens, Mar. 2018, pp. 1–10. [209] J. Deng, Z. Zhang, E. Marchi, and B. Schuller, “Sparse autoencoder-based feature transfer learning for speech emotion recognition,” in Proc. Humaine Association Conference on Affective Computing and Intelligent Interaction, Geneva, Sep. 2013, pp. 511– 516. [210] D. Xi, F. Zhuang, G. Zhou, X. Cheng, F. Lin, and Q. He, “Domain adaptation with category attention network for deep sentiment analysis,” in Proc. The Web Conference, Taipei, Apr. 2020, pp. 3133– 3139. [211] Y. Zhu, D. Xi, B. Song, F. Zhuang, S. Chen, X. Gu, and Q. He, “Modeling users’ behavior sequences with hierarchical explainable network for cross-domain fraud detection,” in Proc. The Web Con- ference, Taipei, Apr. 2020, pp. 928–938. [212] J. Tang, T. Lou, J. Kleinberg, and S. Wu, “Transfer learning to infer social ties across heterogeneous networks,” ACM Trans. Inf. Syst., vol. 34, no. 2, pp. 1–43, Apr. 2016. [213] L. Zhang, L. Zhang, D. Tao, and X. Huang, “Sparse transfer man- ifold embedding for hyperspectral target detection,” IEEE Trans. Geosci. Remote Sensing, vol. 52, no. 2, pp. 1030–1043, Feb. 2014. [214] F. Zhuang, K. Duan, T. Guo, Y. Zhu, D. Xi, Z. Qi, and Q. He, “Transfer learning toolkit: Primers and benchmarks,” 2019, arXiv:1911.08967v1. [215] K. Saenko, B. Kulis, M. Fritz, and T. Darrell, “Adapting visual category models to new domains,” in Proc. 11th European Conference on Computer Vision, Heraklion, Sep. 2010, pp. 213–226. [216] Z.C. Lipton, “The mythos of model interpretability,” ACM Que., vol. 16, no. 3, May 2018, pp. 1–27.